Что меряем
Главная метрика — доля чисел эталона, которые модель поставила в правильную строку и правильную колонку. Считается по каждой странице, потом усредняется по страницам: иначе три самые большие страницы цифровых PDF дали бы треть веса.
- Строка находится по подписи (названию показателя): подписи сравниваются по буквам, без пробелов и знаков, латинские двойники приводятся к кириллице (
смH2O=смН2О). Если подписи совпадают у нескольких строк, выбирается та, у которой больше общих чисел. - Колонка — по сетке таблицы с учётом
rowspan/colspan. Номера колонок не обязаны совпадать с эталоном: важно, чтобы все числа одной колонки эталона оказались в одной колонке ответа. - Числа сравниваются по знаку и цифрам:
1 234,5,1,234.5,(1 234,5)и−1234,5— одно и то же число с точностью до знака. Флаги в ячейке (109,8 Н,12,5%) не мешают. - Ответ может быть в HTML или markdown, с разметкой координат или без неё.
Вспомогательные метрики: доля найденных чисел (где угодно на странице), доля чисел в правильной строке, TEDS и TEDS-struct — сходство дерева таблицы с эталоном (только на синтетике, где эталон — HTML).
Набор
Три части, у каждой свой независимый источник эталона.
| Часть | Что внутри | Эталон | Страниц | Чисел |
|---|---|---|---|---|
| A | цифровые PDF: МСФО-отчётность 13 компаний, вестники ЦБ | текстовый слой PDF | 29 | 1 563 |
| B | синтетика: 6 видов таблиц | HTML, из которого нарисована страница | 60 | 10 326 |
| C | реальные сканы: постановления с pravo.gov.ru, смета 1916 года, 2 страницы MWS | переписан вручную с картинки | 10 | 371 |
A и B есть в двух видах: чистый рендер и «под скан» — с наклоном, шумом, ксерокопией или фото на телефон (augraphy).
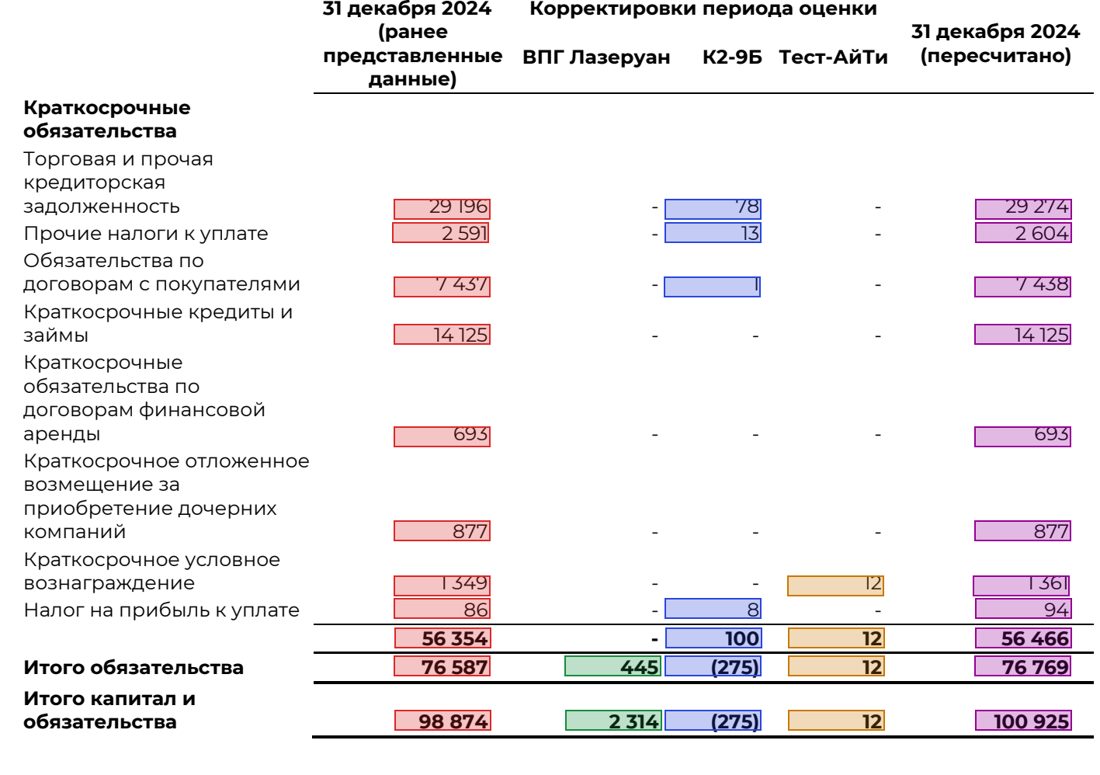
Часть A. Из ~1400 PDF на машине после дедупликации осталось 182 уникальных документа, таблицы нашлись в 16. Страницы отбирались автоматически: текстовый слой русский и не битый, под ним нет скана со скрытым OCR, есть таблица хотя бы с 15 числами в двух колонках. Выкинуты оглавления, диаграммы (подписи столбиков похожи на строки таблицы) и развороты из двух страниц.
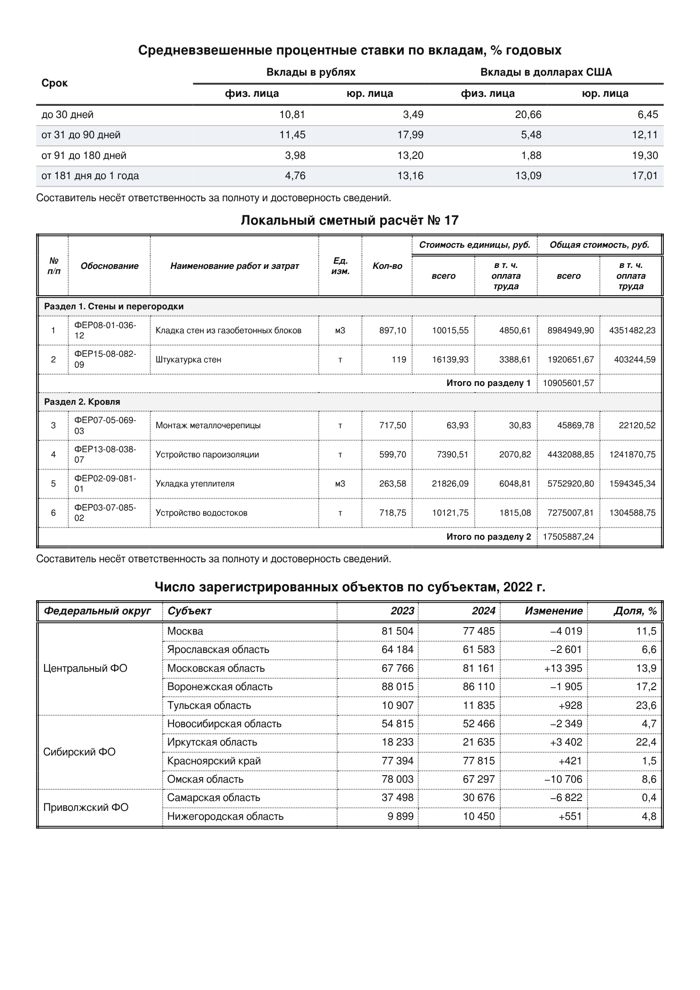
Часть B. Шесть видов таблиц, которых не было в данных для дообучения LightOnOCR: локальная смета с разделами и двухуровневой шапкой, помесячная таблица до 14 колонок, бухгалтерский баланс РСБУ с кодами строк, таблица по регионам с объединёнными ячейками по федеральным округам, расчётная ведомость с копейками, ставки по вкладам. Четыре стиля оформления и четыре шрифта — тоже не из обучения. Формат чисел (разряды, вид отрицательных) один внутри таблицы и меняется между таблицами. Страница заполнена на ~75 %, на ней 2–4 таблицы. Перед сохранением проверяется, что ни одна ячейка не переполнена и блоки не пересекаются.
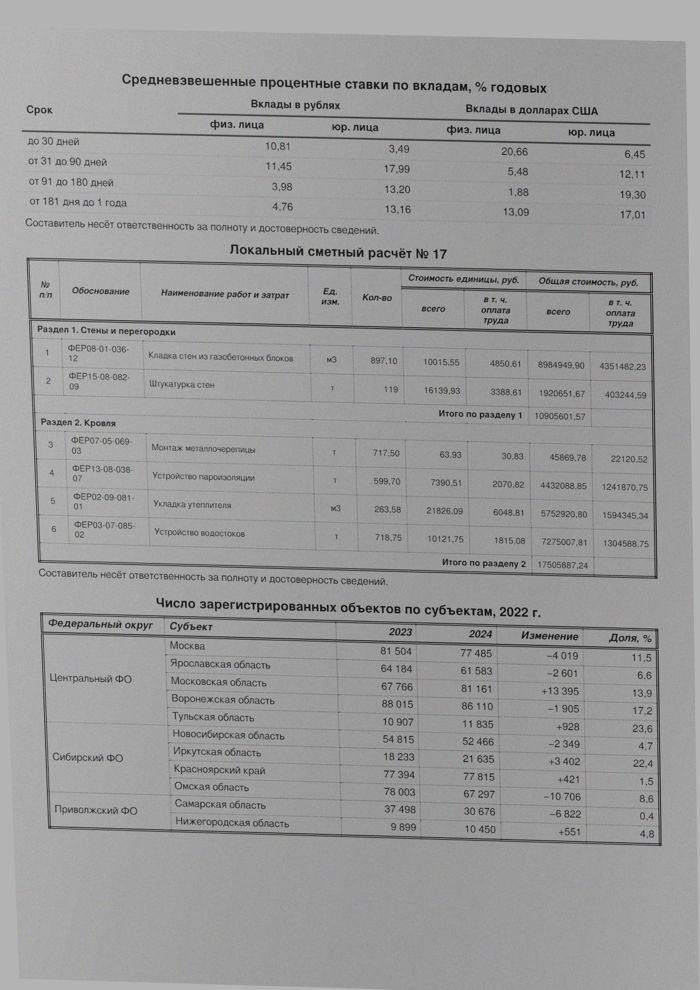
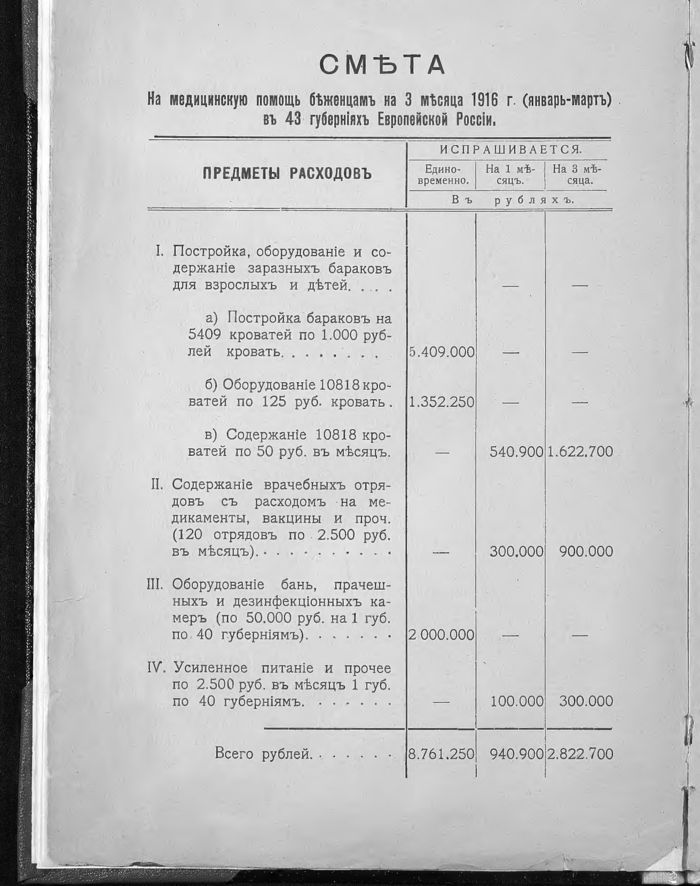
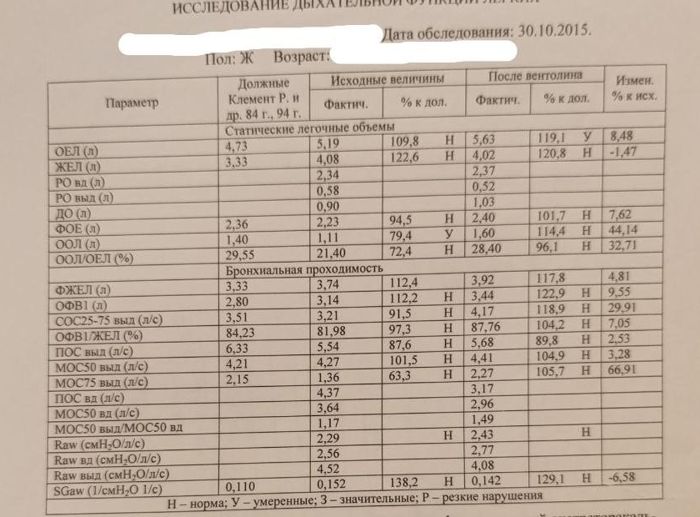
Часть C. Реальных сканов с проверенными таблицами мало, поэтому эталон переписан вручную с увеличенных фрагментов: распределение субсидий, координаты границ участка, штатное расписание, оклады, поправки к госпрограмме, смета 1916 года в дореформенной орфографии, протокол спирометрии (фото с телефона) и справка банка. Каждое расхождение с моделями потом перепроверялось по картинке — их не нашлось.
Что пришлось исправить по дороге
Каждую часть проверяли глазами на случайных страницах, и почти каждая проверка находила дефект — в эталоне или в способе подсчёта:
- Утечка обучающих документов. Один и тот же отчёт лежал под разными именами (
X.pdf,X_ocr.pdf,catalog-X-…), а файл из набора «проблемных PDF» оказался испорченной копией отчёта, на котором обучалась LoRA. Дубли теперь ищутся по тексту первых страниц и по нормализованному имени. - Пропавшие запятые. В вестниках ЦБ в текстовом слое нет десятичной запятой: на картинке
23,3, в тексте233. Отсюда правило сравнивать числа только по цифрам. - Обрезанные подписи. Подпись, перенесённая на несколько строк, попадала в эталон последней строкой («год» вместо «Итого совокупный доход за год»). Теперь строки текста над строкой с числами приклеиваются к подписи.
- Мусор вместо таблиц. В эталон попадали оглавления, номера разделов, колонтитулы и подписи диаграмм.
- Скорер. Он считал колонку по номеру ячейки внутри
<tr>и наказывал модель за правильныйrowspan, не читал markdown-таблицы, резал1,234.56на два числа и путал строки, когда модель выносила флаги «Н»/«У» в отдельные ячейки («ЖЕЛ Н Н» похоже на «ФЖЕЛ»). На эталонных ответах после исправлений — ровно 1.0, на ответе со сдвигом каждой второй строки — 0.55. - Ошибка в MWS. Эталон страницы MWS 1145 расходится с картинкой: часть строк протокола в нём выдумана. Для этого бенча страница переписана заново.
Результаты
Все модели — на одних и тех же картинках. Qwen получал промпт «распознай страницу, таблицы — в HTML с rowspan/colspan». LightOnOCR-3 — без промпта (режим производителя) и с инструкцией grounding: в этом режиме обучалась LoRA, поэтому до/после сравниваются в нём.
| Модель | A чистые | A «скан» | B чистые | B «скан» | C сканы |
|---|---|---|---|---|---|
| Qwen3.8-27B | 0.943 | 0.949 | 0.999 | 0.987 | 1.000 |
| LightOnOCR-3 0.8B, по умолчанию | 0.950 | 0.942 | 0.993 | 0.984 | 1.000 |
| LightOnOCR-3 0.8B, grounding | 0.959 | 0.955 | 0.999 | 0.987 | 1.000 |
| LightOnOCR-3 0.8B + LoRA v2, grounding | 0.619 | 0.512 | 0.809 | 0.733 | 0.770 |
Доля чисел в правильной строке и колонке, среднее по страницам.
Структура таблиц на синтетике (B), где эталон — HTML:
| Модель | TEDS чистые | TEDS «скан» | TEDS-struct чистые | TEDS-struct «скан» |
|---|---|---|---|---|
| Qwen3.8-27B | 0.980 | 0.967 | 0.986 | 0.980 |
| LightOnOCR-3 0.8B, по умолчанию | 0.962 | 0.953 | 0.969 | 0.963 |
| LightOnOCR-3 0.8B, grounding | 0.975 | 0.960 | 0.980 | 0.968 |
| LightOnOCR-3 0.8B + LoRA v2 | 0.768 | 0.660 | 0.776 | 0.679 |
По структуре Qwen чуть точнее, но разница 0.005–0.007 — без повторных прогонов это нельзя отличить от шума.
На реальных сканах обе базовые модели безошибочны. Разница — на сложной вёрстке цифровых PDF.
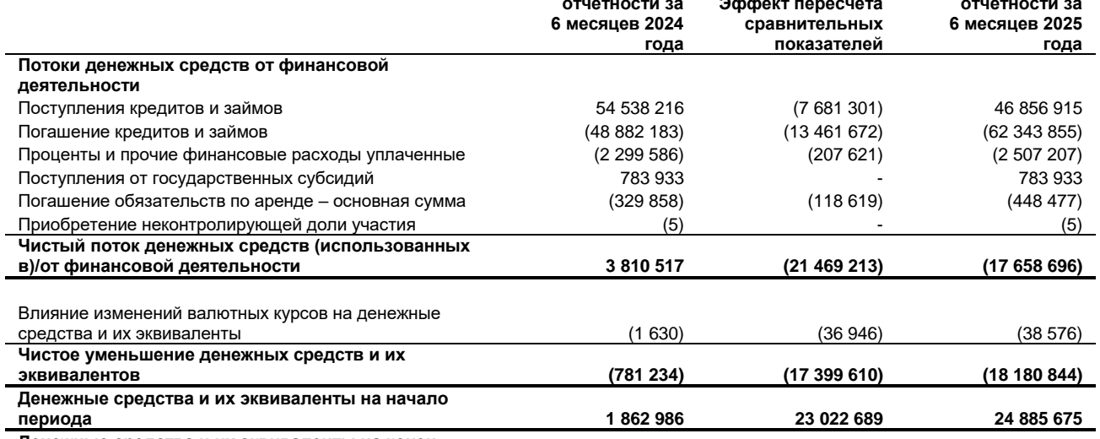
Qwen сдвигает строки. На отчёте «Русагро» он прочитал все числа верно, но разложил их со сдвигом на одну строку: «Погашение кредитов и займов» получила числа строки «Проценты…», и так до конца таблицы. Доля найденных чисел — 100 %, на своих местах — 10 %. Ради ловли таких ошибок и нужна главная метрика.
LoRA v2 таблицы ломает. На 8–11 из 29 страниц цифровых PDF (чистые и «скан»), на 10–12 из 60 синтетических и на 2 из 10 сканов дообученная модель не выдаёт таблицу вовсе: ячейки идут отдельными строками текста с координатами. Числа при этом прочитаны (найдено 96 %), но структуры нет. Там, где таблица есть, v2 тоже хуже базы: 0.82–0.85 против 0.96 на цифровых PDF, 0.88 против 1.00 на сканах. На 7 синтетических страницах ответ обрывается по лимиту длины. Это сходится с прежним наблюдением в исследовании дообучения: на отложенных таблицах v2 уже была хуже базы.
Скорость здесь не мерили. Qwen тратил 23–78 с на страницу, LightOnOCR — 6–18 с, но серверы и число параллельных запросов разные, прогоны шли не через раз. Это ориентир, не замер.
Когда что брать
- Числа из таблиц русских документов — LightOnOCR-3 0.8B в режиме grounding. По главной метрике он не уступает Qwen3.8-27B, а на цифровых PDF реже путает строки.
- LoRA v2 для таблиц не использовать. Она подняла рукопись на MWS, но здесь теряет таблицы целиком.
- Сравнивать два сильных VLM между собой на этом бенче почти нечем: на синтетике и сканах оба дают 0.99–1.00. Для такого сравнения нужны страницы сложнее — повёрнутые таблицы, таблицы через разворот, рукописные значения.
Ограничения
- Часть A — почти одна финансовая отчётность: 25 страниц МСФО и 4 страницы вестников ЦБ. Счетов, актов и смет среди цифровых PDF не нашлось, их заменяет синтетика.
- Часть C маленькая: 10 страниц, 371 число. Она подтверждает, что выводы переносятся на реальные сканы, но мелкую разницу между моделями не различит.
- «Сканы» в частях A и B — имитация. Настоящие сканы есть только в C.