Правило данных
Обучаться только на разметке, которая верна по построению:
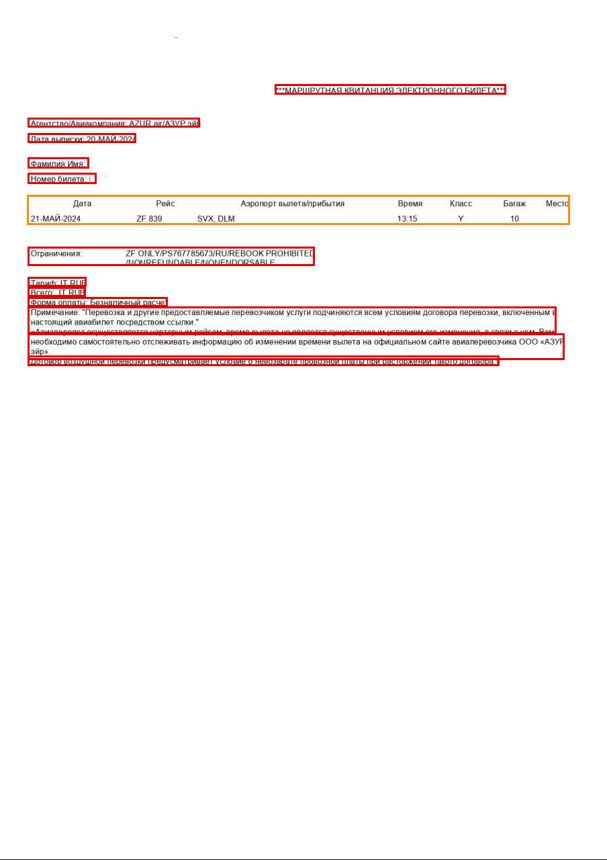
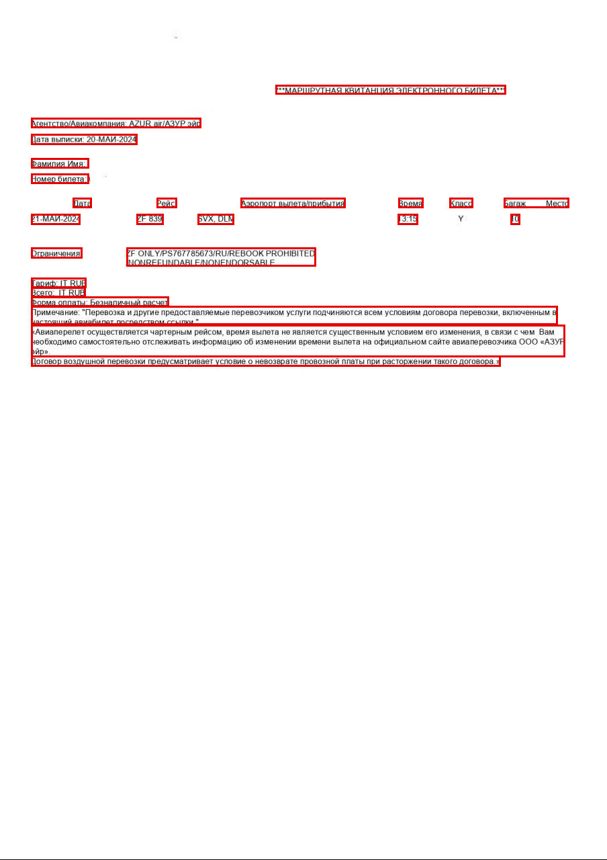
- синтетика — страницы рисуются из HTML в Chromium, текст и рамки каждого блока снимаются из DOM, поэтому совпадают с пикселями точно;
- электронные PDF — текст и координаты берутся из текстового слоя.
Псевдоразметку от сильных моделей (например, ответы Glimmer на реальных сканах) не использовали: тогда модель училась бы ошибкам учителя. Все рамки проверялись автоматически (пересечение блоков больше 5 % — брак) и глазами на нескольких страницах каждого источника.
Оценка — MWS-Vision-Bench, 120 страниц, режим grounding, по три повтора каждой модели. Повтор базовой модели гуляет в пределах ±0.004, это и есть шум.
Итерации
| Версия | Что в обучении | MWS 120 | Печатные | Рукопись |
|---|---|---|---|---|
| База | — | 0.732 | 0.849 | 0.349 |
| v0 | 5 шаблонов судебных писем, 600 синтетических таблиц, 207 страниц PDF | 0.713 | — | 0.297 |
| v1 | 15 семейств макетов, 147 PDF, письма, таблицы; брак рамок отсеян | 0.715 | 0.857 | 0.247 |
| v1b | те же данные, адаптер только на языковой части | 0.712 | 0.840 | 0.290 |
| v2 | v1 + 290 страниц настоящих школьных тетрадей | 0.762 | 0.857 | 0.452 |
Результаты v0 недействительны: в данных были пересекающиеся рамки. Обучение — LoRA r=32 на языковой части и визуальном энкодере (23.4 млн параметров), 57–74 шага, 36–47 минут на RTX 3090, около 5 ГБ видеопамяти.
Что дала синтетика: рамки
На отложенных страницах модель уверенно выучила нашу разметку блоков. Доля блоков с IoU ≥ 0.5 у v1:
| Отложенный набор | База | v1 |
|---|---|---|
| Все 488 страниц | 0.72 | 0.91 |
| Семейства макетов, которых не было в обучении (протокол, двухколоночная статья, чек) | 0.61 | 0.89 |
| Новые электронные PDF | 0.69 | 0.80 |
Оговорка: это частично согласие с нашим способом нарезать блоки. На реальных сканах эталонных рамок нет, поэтому там сравнивали только на глаз.
Что сломала синтетика: почерк
Печатный текст после дообучения на синтетике стал чуть лучше, а рукопись провалилась: 0.349 → 0.247. Синтетические «рукописные» шрифты не похожи на настоящий почерк. Гипотеза, что виноваты адаптеры на визуальном энкодере, не подтвердилась: v1b без них тоже хуже базы.
Тогда собрали настоящие рукописные данные: 2482 страницы из открытых наборов школьных тетрадей (Sber school_notebooks_RU и другие). Наклон выровнен, рамки построчные и без пересечений, порядок строк — по геометрии, текст проверен глазами. При сборке нашлась утечка: страница MWS 900 на 39 % совпадала с тетрадями по 6-граммам. Такие страницы отсекаются отдельной проверкой.
290 таких страниц в обучении v2 подняли рукопись на MWS с 0.349 до 0.452, а общий балл — с 0.732 до 0.762. Печатные страницы не пострадали.
Обратная сторона v2
На отложенных таблицах v2 стала хуже базы: сходство ячеек 0.929 → 0.895. Синтетические таблицы база и так читает почти идеально (0.97–0.98), и обучение на них мало что даёт.
Тот же опыт на Indra OCR
Распознаватель строк Indra OCR — маленькая модель на CPU — дообучили на тех же тетрадях:
| Версия | MWS 120 | Печатные | Рукопись |
|---|---|---|---|
| База | 0.649 | 0.812 | 0.113 |
| v1: строки тетрадей | 0.681 | 0.804 | 0.274 |
| v2: + больше печатных строк | 0.684 | 0.807 | 0.280 |
| v3: + 1000 страниц, собранных из отдельных слов | 0.681 | 0.801 | 0.287 |
На отложенных тетрадях весь конвейер Indra вырос с 0.18 до 0.77, а на рукописи MWS упёрся в 0.28. Объём строк больше не помогает: в MWS другой почерк и другие носители, нужна разнообразная рукопись.
Итог
- Синтетика с точной разметкой хорошо учит структуре: рамкам блоков и конвенции разметки.
- Почерку синтетика не учит и даже портит его. Нужны настоящие рукописные страницы.
- Любой набор для обучения нужно проверять на пересечение с бенчмарком: одна совпавшая страница незаметно завышает результат.