Что это за набор
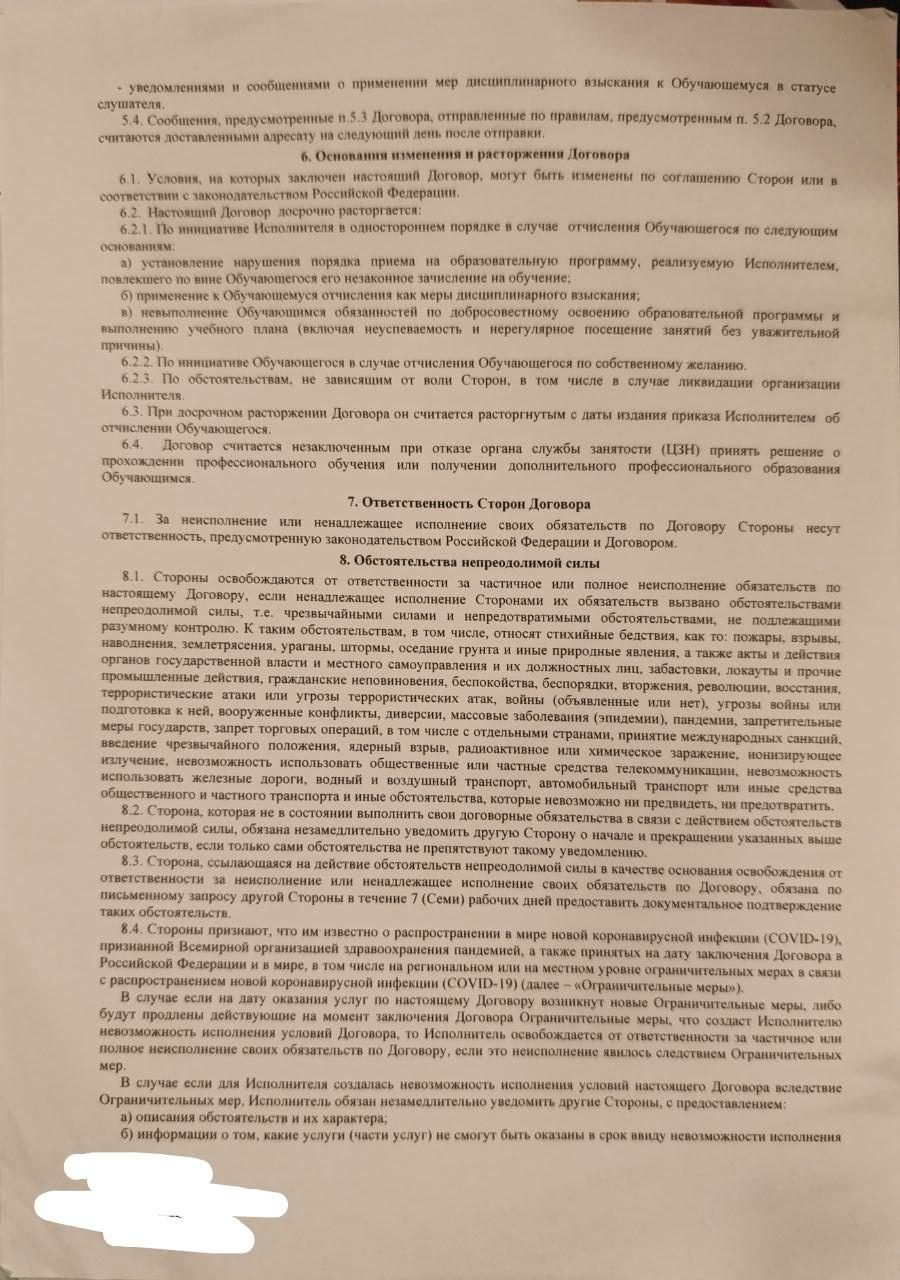
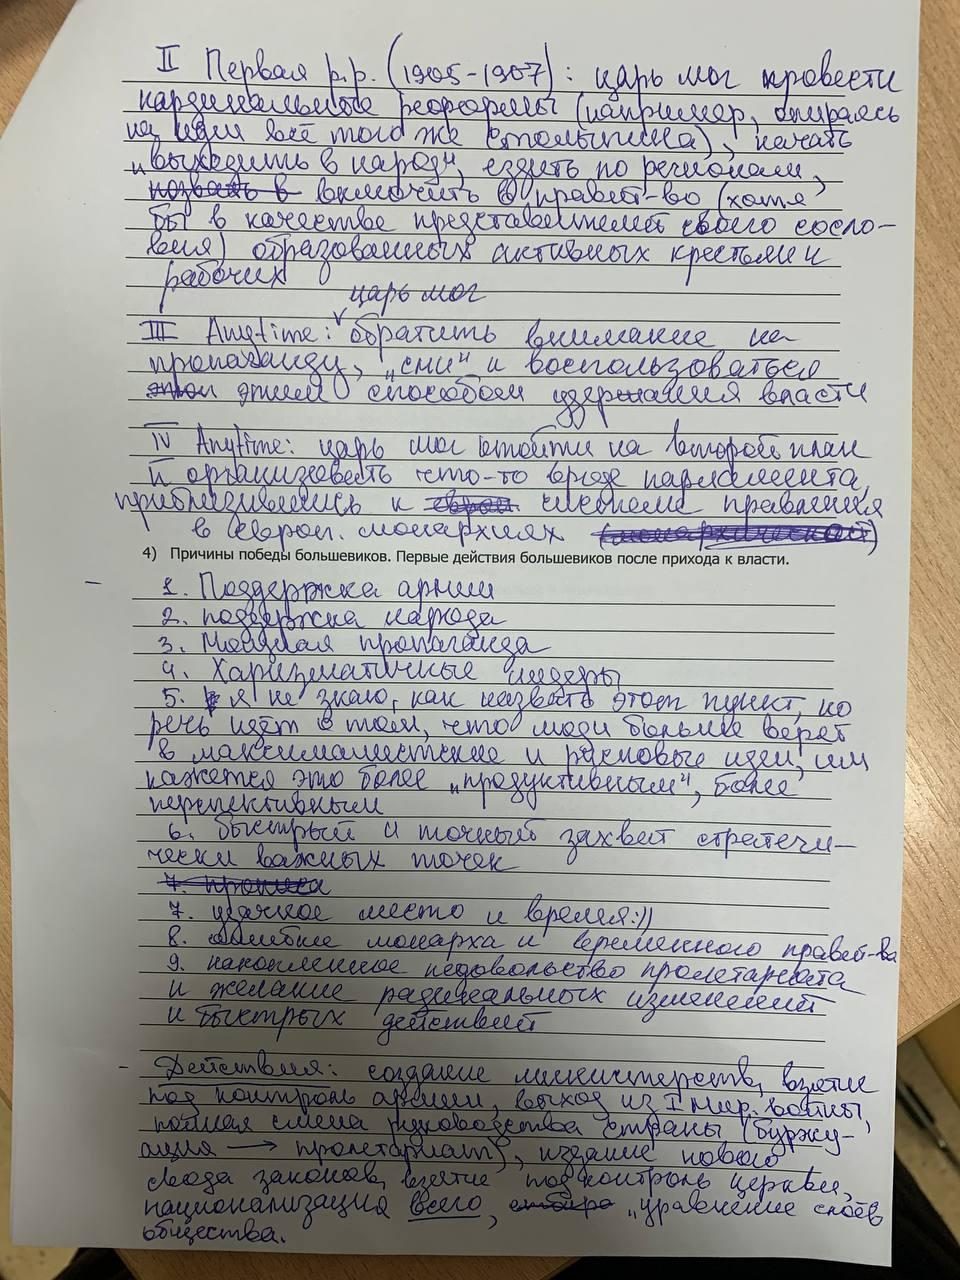
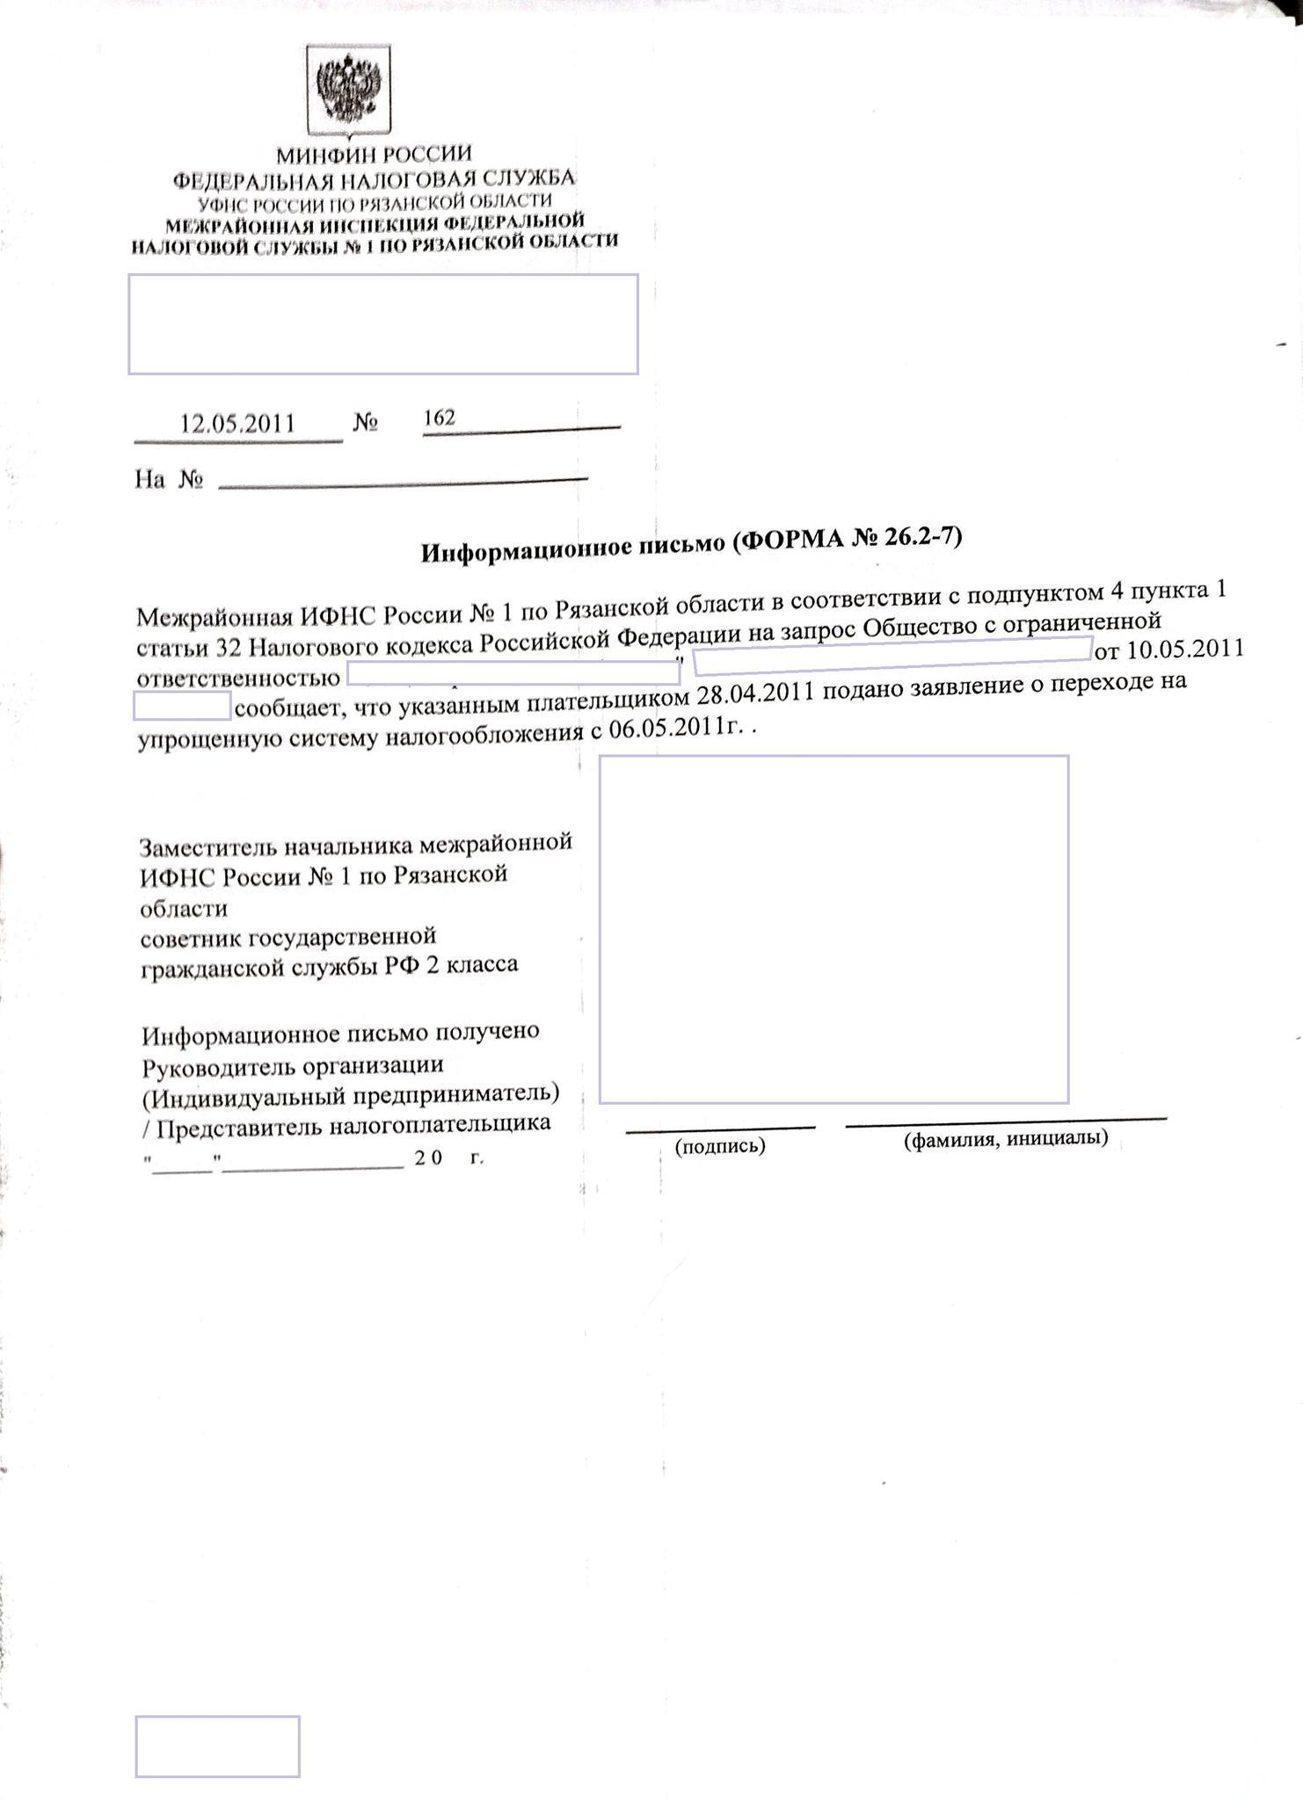
MWS-Vision-Bench — открытый набор от MTS AI: реальные русские документы, сфотографированные или отсканированные. Договоры, справки, протоколы, грамоты, медицинские выписки, а также школьные и студенческие тетради. Персональные данные в нём уже закрыты белыми плашками.
В исходном наборе 144 задания. 120 из них — «распознай всю страницу». Остальные 24 спрашивают про фрагмент: «выведи пункты 5–7», «только абзац «Внимание»». Такие вопросы проверяют, понимает ли модель инструкцию, а не насколько хорошо она читает. OCR-движки без промпта на них заведомо проваливаются. Поэтому с 23.10.2026 лидерборд считается только по 120 страницам полного текста.
Как считается балл
Для каждой страницы считаются четыре метрики сходства ответа модели с эталоном:
- BLEU — совпадение n-грамм слов;
- METEOR — совпадение слов с учётом словоформ;
- F-measure — совпадение набора слов;
- 1 − нормированное расстояние Левенштейна — посимвольная близость.
Балл страницы — среднее этих четырёх, балл модели — среднее по 120 страницам. Шкала от 0 до 1. Порядок строк и разметка влияют на балл: модель, которая прочитала все слова, но перемешала колонки, получит меньше.
Все модели посчитаны одним и тем же скорером из репозитория бенча, на одних и тех же картинках. Поэтому баллы в лидерборде можно сравнивать между собой. Абсолютное значение ниже, чем «процент верных символов»: даже идеальное чтение редко даёт больше 0.95 из-за расхождений в переносах строк и форматировании.
Печатные и рукописные страницы
У каждой страницы есть тип: скан или фото печатного документа, бланк, чистый текст, текст с графикой, скриншот, рукопись. Метки пришли из служебного прогона и не являются частью официального набора. Перед публикацией все 120 страниц были отрисованы и сверены с метками на глаз. Две страницы с меткой «без метки» оказались рукописными конспектами (954 и 1011), их перенесли в рукопись. На сайте 90 печатных и 30 рукописных страниц. В старых отчётах было 92 и 28, поэтому цифры «печатные» и «рукопись» здесь отличаются от них в третьем знаке. Общий балл не меняется.
Ошибки в эталоне
Эталон тоже писали люди, и он не идеален. При разборе страниц, на которых сильные модели расходятся с эталоном, нашлись настоящие ошибки:
| Страница | Что не так |
|---|---|
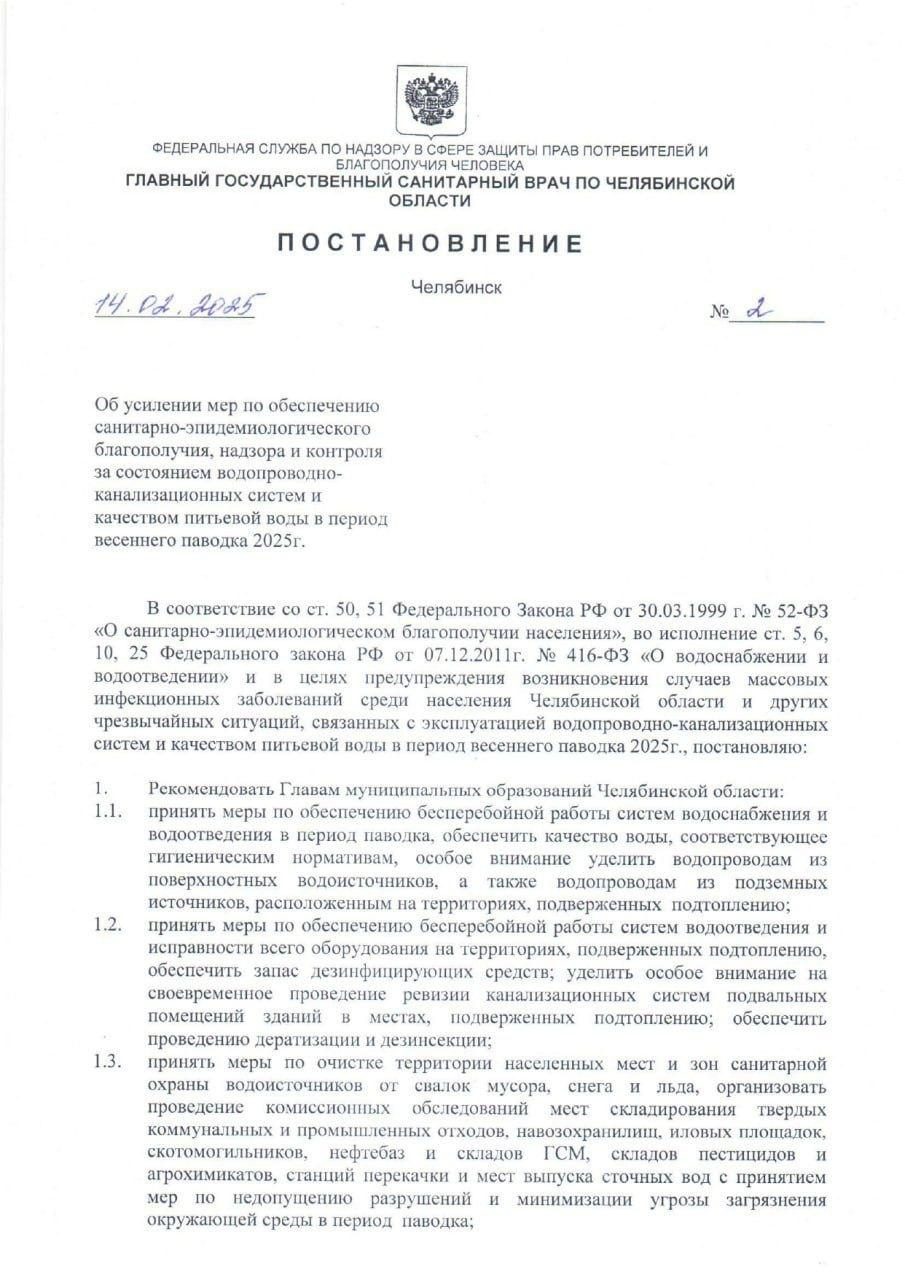
| 3 | На скане дата «14.02.2025», в эталоне «14.07.2025». Сильные модели читают верно. |
| 1145 | В строке ОФВ1 на скане 2,80 / 3,14 / 112,2, в эталоне 2,84 / 2,14 / 75,4. |
Ещё на страницах 78 и 372 аудит отметил расхождения в числе и в дате.
Эталон не исправлялся: все модели оцениваются по одному и тому же файлу, ошибки занижают баллы всех примерно одинаково. Проверены глазами не все страницы, поэтому таких мест может быть больше.
Скорость
Скорость в лидерборде — справочная. Модели запускались в своих родных условиях: крупные VLM через llama.cpp с квантованием по 4 параллельных запроса, специализированные OCR-модели через vLLM с десятками параллельных запросов, Indra на CPU. Поэтому «секунды на страницу» у Qwen и «страницы в секунду» у LightOnOCR напрямую не сравниваются. В статье каждой модели указано, как именно мерили. Всё железо одно: RTX 3090 24 ГБ, Ryzen 9 5950X.
Чего бенч не измеряет
- Структуру таблиц: строки и ячейки оцениваются только как текст.
- Рамки блоков и порядок чтения отдельно от текста.
- Понимание документа: извлечение полей, ответы на вопросы.
- Устойчивость к поворотам и сильным искажениям: таких страниц в наборе единицы.
Какие страницы в наборе