Проблема
Детектор строк находит строки, распознаватель их читает, а дальше строки нужно расставить в порядке чтения. Простая сортировка сверху вниз и слева направо на многоколоночной странице чередует левую и правую колонки построчно. Буквы прочитаны верно, а текст нечитаем, и метрики сравнения с эталоном падают в разы.
На страницах MWS исправление только этого порядка снизило ошибки нашего OCR с 11.95 % до 8.61 % (подробнее — в статье про PP-OCRv6). Здесь разобраны более трудные макеты: широкие заголовки поверх колонок, короткие абзацы, три независимые статьи на одной полосе.
Принцип: блоки задают порядок, но не режут текст
Модель разметки PP-DocLayoutV3 находит на странице блоки: заголовки, абзацы, таблицы, рисунки. Если просто читать блоки в том порядке, который возвращает модель, или распознавать текст только внутри блоков, становится хуже: рамки покрывают не весь текст, и строки теряются.
Поэтому блоки используются только для одного: найти вертикальный промежуток между колонками и границы зон, в которых колонки действуют. Все распознанные строки остаются на месте, включая те, что не попали ни в один блок. Меняется только их порядок.
Широкие заголовки: Вестник Банка России
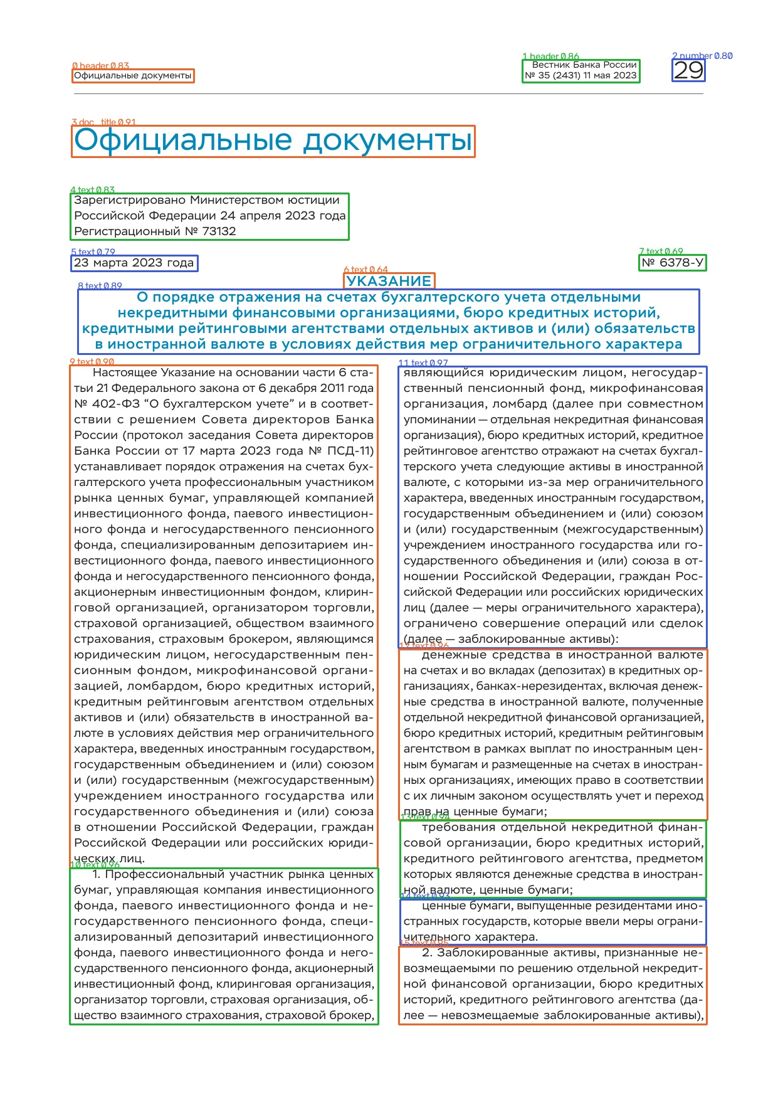
Правило двух колонок искало промежуток по всей высоте страницы. Широкие заголовки и вводная часть его перекрывали, и OCR снова чередовал левые и правые строки. Новый режим sections делит страницу на горизонтальные участки и ищет колонки в каждом отдельно.
| Страница PDF | Расхождений до | Расхождений после |
|---|---|---|
| 31 | 2657 | 75 |
| 32 | 2753 | 38 |
| 33 | 2868 | 86 |
| 34 | 1813 | 304 |
Сравнение шло с текстовым слоем PDF, страницы — электронные, растеризованные. Всего ошибок стало 503 вместо 10 091. На 144 страницах MWS это правило ничего не изменило, то есть ничего и не сломало.
Вторая версия правила связывает зоны колонок через короткие абзацы и подзаголовки. На другом выпуске того же издателя одна страница из шести улучшилась (322 → 31 расхождение), пять не изменились — и на чистой копии, и на искусственно испорченной (100 DPI, размытие, наклон 0.8°, JPEG).
Три колонки и общие заголовки: журналы UCI
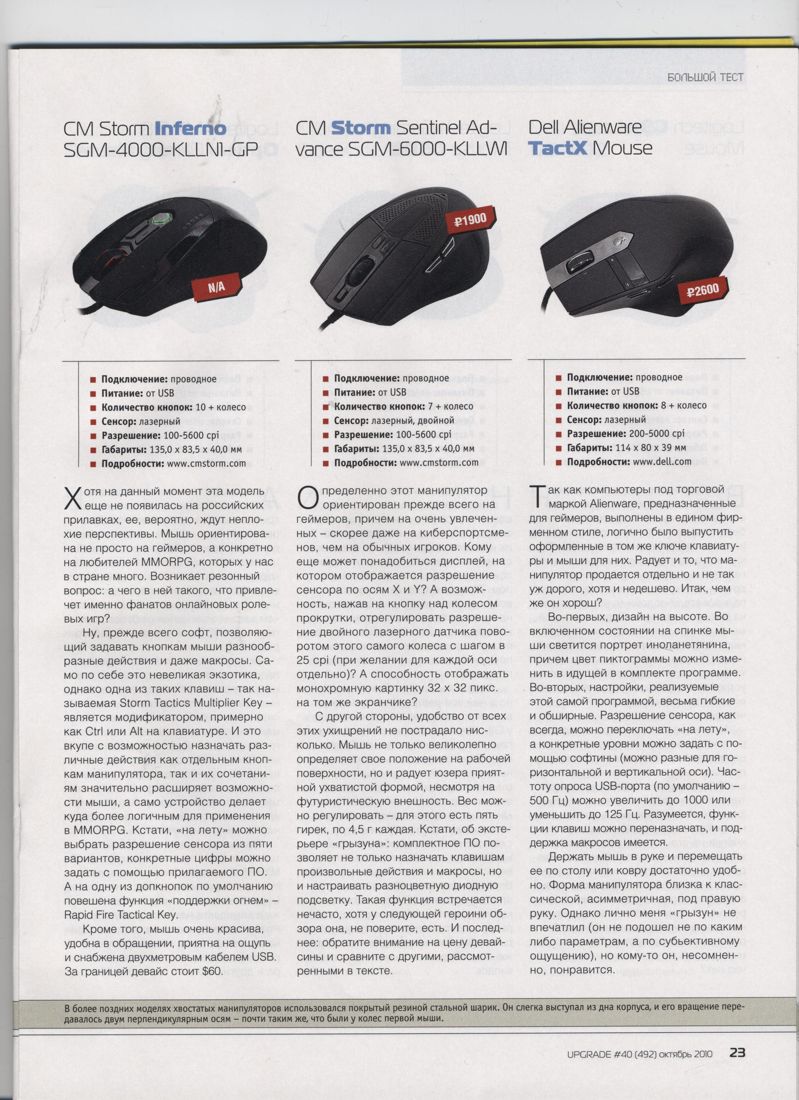
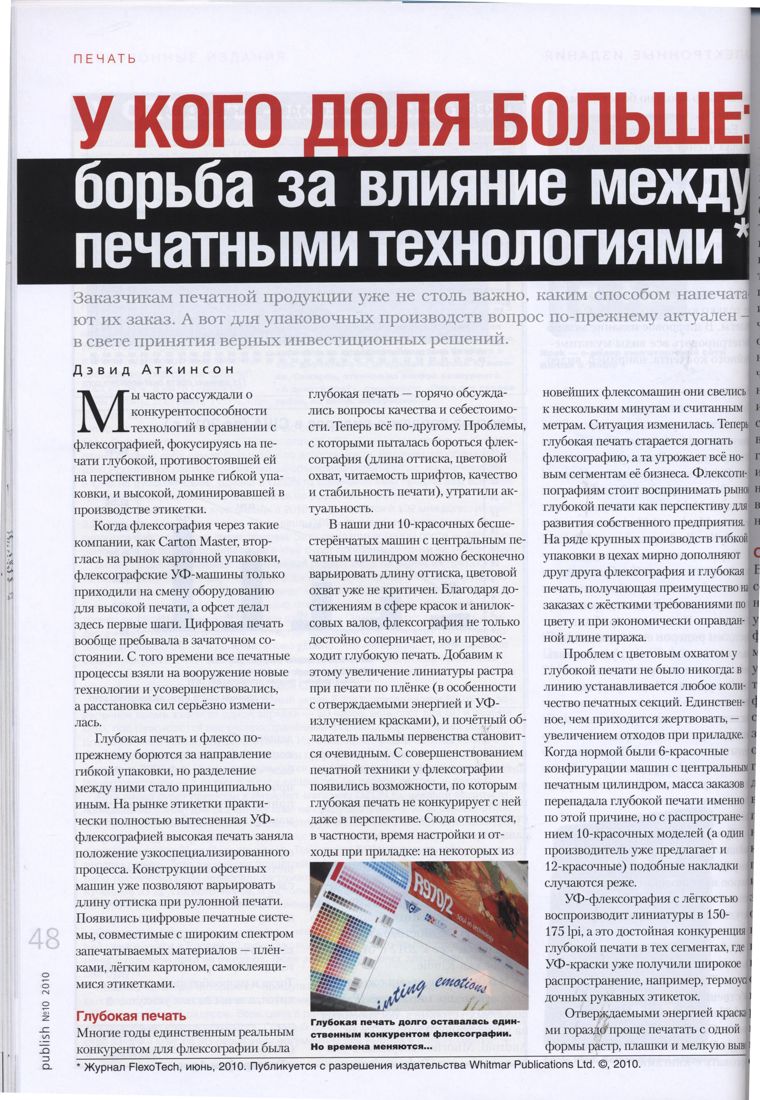
Правило трёх колонок использует текстовые блоки, чтобы прочитать сначала левую статью, потом среднюю и правую, вместе с их заголовками и характеристиками. Подтверждённые три колонки проверяются раньше конкурирующей двухколоночной сортировки. Узкая вертикальная подпись на полях не расширяет зону до колонтитула.
Метрика — число пар строк из разных колонок, стоящих в неправильном порядке. На страницах разработки она стала нулевой: 2996 → 0 на полосе с мышами, 2135 → 0, 2083 → 0 и 659 → 0 на трёх других сканах.
Ограничение. На восьми заранее отобранных новых сканах правило трёх колонок не сработало ни разу. Его переносимость не подтверждена. На четырёх из них сработали прежние двухколоночные правила: например, на uci-31 неправильных пар стало 0 вместо 466.
Какая модель разметки лучше
На восьми реальных сканах газет и журналов из UCI с ручными масками текста:
| Модель | Покрытие текста | Точность маски | IoU |
|---|---|---|---|
| PP-DocLayoutV3 | 94.2 % | 78.9 % | 75.2 % |
| PP-DocLayout_plus-L | 89.5 % | 77.1 % | 70.7 % |
На электронных страницах Вестника ЦБ полностью вне рамок V3 оказались 4 строки из 386, у plus-L — 8. Пропуски — заголовки «УКАЗАНИЕ» и пункты сразу под ними.
Как Surya строит порядок
Для сравнения разобрали, как это делает Surya OCR 2. Её layout — генеративная модель: она получает картинку и отвечает JSON-массивом областей (label, bbox, count). Порядок чтения — просто порядок элементов в ответе, отдельной сортировки нет. На проверенных документах порядок оказался правильным, но гарантии это не даёт: если модель выдаст области в другом порядке, текст тоже переставится.
Итог
- Порядок чтения — главный источник ошибок OCR на многоколоночных страницах, и он исправляется без переобучения.
- Блоки layout полезны как подсказка о промежутках и зонах, но не как источник порядка и не как маска для распознавания.
- Правила для двух колонок переносятся на новые документы, правило трёх колонок — пока нет.
- Режим:
--layout-model PP-DocLayoutV3 --layout-order sections.