Задача
Нужен локальный OCR для русских документов без генеративной модели: предсказуемый, с координатами каждой строки, без петель и выдуманного текста. За основу взят PaddleOCR: детектор строк PP-OCRv6 medium и распознаватель, дообученный на русском. Официальный PP-OCRv6 кириллицу не поддерживает, словарь с ней добавлен при дообучении.
Качество мерили на 119 полностраничных заданиях MWS-Vision-Bench метрикой CER — долей символов, которые нужно исправить, чтобы получить эталон. Важная оговорка: эти страницы использовались и при обучении, и при подборе каждого правила. Поэтому все цифры ниже — проверка на знакомых страницах, а не оценка на новых документах. В общем лидерборде итоговая модель стоит с пометкой.
Итог по шагам
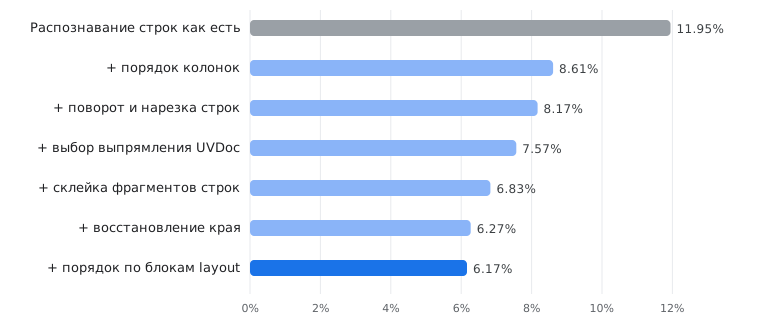
| Шаг | CER | Ошибок в символах |
|---|---|---|
| Распознавание строк как есть | 11.95 % | 32 036 |
| + порядок колонок | 8.61 % | 23 091 |
| + поворот страницы и нарезка наклонных строк | 8.17 % | 21 911 |
| + автоматический выбор выпрямления UVDoc | 7.57 % | 20 290 |
| + склейка фрагментов одной строки | 6.83 % | 18 314 |
| + восстановление края после выпрямления | 6.27 % | 16 813 |
| + порядок колонок по блокам layout | 6.17 % | 16 533 |
Для сравнения: лучший сохранённый прогон Surya OCR 2 на тех же страницах — 8.39 %.
Главный вывод: буквы читались почти правильно
Первый же разбор расхождений с Surya показал, что разница между моделями — не в распознавании символов. Если только переставить уже распознанные строки двухколоночных страниц в правильном порядке, CER падает с 11.95 % до 8.61 %. Так закрывается 94 % разрыва с Surya, хотя меняются всего 9 страниц. Эталон для выбора порядка не использовался.
Отсюда план работ: сначала геометрия и порядок чтения, потом всё остальное.
Геометрия страницы
Поворот и наклонные строки. Страницы, снятые под углом, сначала разворачиваются по классификатору ориентации, а строки нарезаются с учётом наклона. На всех 144 страницах: 14 стали лучше, 2 хуже (на 10 и 2 символа).
Выпрямление UVDoc — только по проверке. UVDoc выпрямляет изогнутые фото, но на ровных сканах иногда обрезает края. Поэтому выпрямление не применяется ко всем страницам подряд. Страница распознаётся в двух вариантах, и выпрямленный принимается, только если в нём сохранились уверенно прочитанные строки, текст у краёв и числа. Эталон в этом выборе не участвует, правило и пороги зафиксированы до первого расчёта. Выбраны три страницы, например на странице 151 ошибок стало 13 вместо 476. Ухудшений нет.
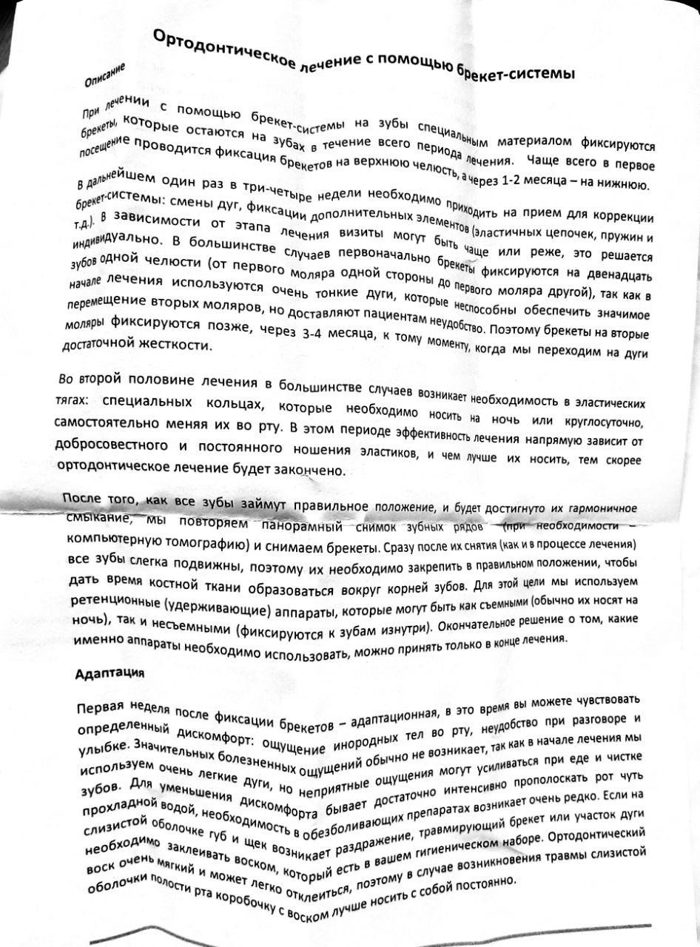
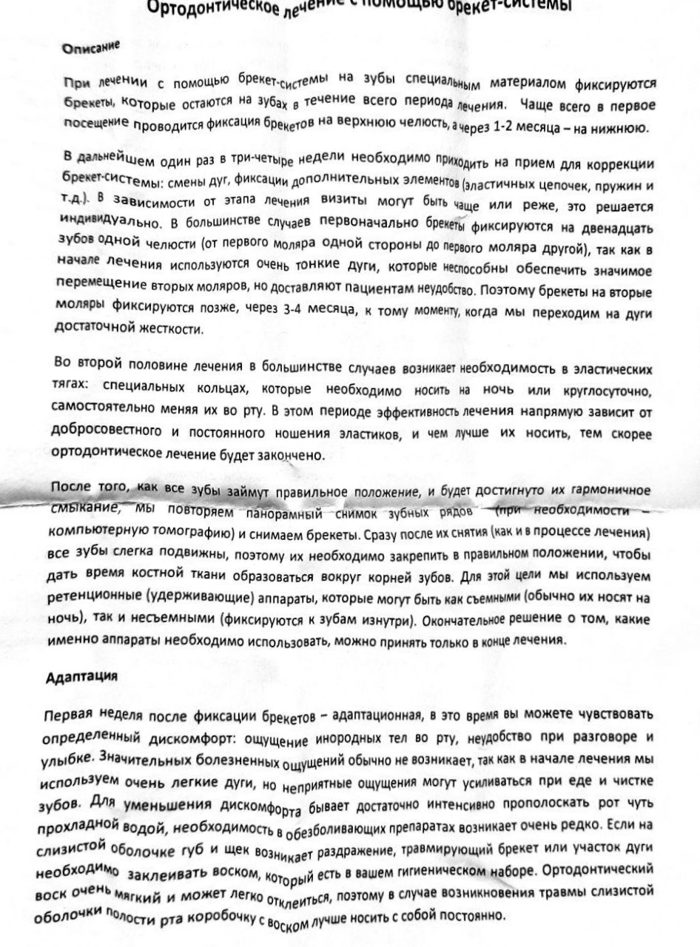
Восстановление края. На странице 1262 выпрямление исправляет почти всё, кроме нижней строки, которую UVDoc склеил с соседним фрагментом. Решение — сопоставить выпрямленную и исходную страницу по точкам изображения, найти исходный фрагмент строки и взять его окончание. Окончание принимается, только если две независимые перечитанные версии совпали. Ошибок на этой странице стало 31 вместо 1532.
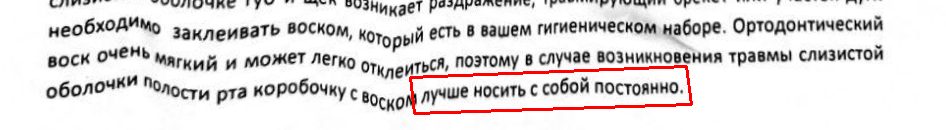
Склейка фрагментов строки. Детектор иногда режет одну строку на части. Соседние фрагменты одной строки теперь собираются слева направо с учётом наклона, а пересекающиеся рамки, разные колонки и заметно разные уровни не объединяются. 44 страницы стали лучше, ухудшений нет.
Layout: помогает только аккуратно
Разметку страницы PP-DocLayoutV3 проверяли тремя способами:
- Брать порядок блоков от модели — хуже: 13 страниц ухудшились, 6 улучшились. На странице 1145 модель пропустила заголовок и дату, на 198 переставила два абзаца.
- Распознавать только внутри найденных блоков — хуже: рамки покрывают не весь текст, на 7 из 8 проверенных страниц текст терялся.
- Брать от блоков только промежуток между колонками — помогает. Строки остаются все, включая те, что вне рамок. Меняется только порядок колонок, и только если промежуток не пересекает ни один блок.
Сравнивали четыре модели разметки: PP-DocLayoutV3, PP-DocLayout_plus-L, Docling Egret-xlarge и Heron-101. Heron оставляет меньше всего строк вне блоков (501 из 6419 против 890 у V3), но покрытие рамками само по себе текст не улучшает. Выбрана V3. На восьми реальных сканах UCI с ручными масками она покрывает 94 % текстовой площади, plus-L — 90 %.
Обучение: веса дали меньше, чем ожидалось
- Основная модель — дообучение на реальных строках из PDF и сканов (6 эпох). Итерации с дополнительной синтетикой (20 тысяч изображений, частотные словари) значимого выигрыша не дали.
- Аугментации. Две серии: разрешение, дефекты скана, поля строки, толщина штриха, настоящий DPI PDF, несколько масштабов входа. Лучшая комбинация (разрешение + дефекты скана) улучшила строки сканов на 2 ошибки из 22. На полном MWS прирост 0.09 балла из 100 в пределах доверительного интервала. Убедительного общего улучшения нет.
- Смешивание весов. Взвешенное среднее исходной модели и двух дообученных с разными аугментациями (25 % + 37.5 % + 37.5 %, включая статистики BatchNorm) — идея model soups. Эти веса стоят в итоговом пресете, но прирост от них не больше шума.
Ширина строки: 1280 или 2048
Распознаватель сжимает строку в окно 48 px высотой и не шире заданной ширины. При ширине 1280 длинная строка низкого разрешения (скриншот, PDF на 180 DPI) сжимается по горизонтали в 1.6 раза, и мелкий шрифт превращается в мусор. На анкете со скриншота средняя уверенность выросла с 0.78 до 0.94 при ширине 2048.
На MWS всё наоборот: 2048 немного хуже (6.25 % против 6.17 %, 72 страницы хуже, 27 лучше), потому что строки там высокие. Компромисс — перечитывать на 2048 только длинные строки с уверенностью ниже 0.95 и принимать новый ответ, только если он увереннее. На MWS это затронуло 5 строк из 5018 и дало 6.15 %, а скорость не изменилась.
Что осталось
- 44 % оставшихся ошибок приходится на 10 страниц.
- Часть «ошибок» — дефекты эталона. На странице 302 в эталоне другие пункты договора: если подставить видимые на скане пункты, ошибок становится 18 вместо 483. На 1145 в таблице другие цифры, на 127 пропущен целый пункт.
- Слабые места: рукопись (личные документы — 0.55 балла против 0.80 у деловых), сложные смешанные макеты, чеки на шумном фоне (на 6 из 8 фото чеков детектор не нашёл ни одной строки).
- Таблицы восстанавливаются только как области, ячеек нет. Этим занимается отдельная работа про структуру таблиц.
Как запустить
.train-venv/bin/python scripts/ocr_best.py document.pdf --out output/document --device gpu:0
Пресет фиксирует веса и параметры. На выходе text.txt, result.json (строки, координаты, области, причины выбранного порядка) и recipe.json с хешами кода и весов. Сохранность выхода проверена на 194 вариантах страниц: все 12 665 строк на месте.