Как устроено извлечение таблицы
Это три разные задачи, и каждую решает свой компонент:
- Найти область. PP-DocLayoutV3 выделяет таблицу на странице (рендер 300 DPI, не больше 12 Мп).
- Восстановить сетку. Модель структуры предсказывает ячейки, строки, столбцы и объединения. Текст она не читает.
- Заполнить ячейки. Строки нашего OCR раскладываются по ячейкам по пересечению координат, одна строка — не больше одной ячейки.
Объединённые заголовки превращаются в rowspan/colspan, продолжение таблицы на следующей странице склеивается в одну логическую таблицу.
Набор
Контрольный корпус: 30 документов, 42 страницы. Часть — сгенерированные документы (счета, реестры отгрузок, расписания, лабораторные журналы) в двух вариантах, электронном и «сканированном». Часть — публичные документы МГУ и МЧС. В нём 14 таблиц и 400 ячеек, но уникальных изображений только 10 (320 ячеек): есть повторы.
Все модели получили одинаковые вырезки таблиц и один и тот же текст от дообученного PaddleOCR. Рамки вырезок взяты из разметки, то есть здесь сравнивается структура внутри известной таблицы, а не поиск таблицы на странице.
Результаты
| Модель | Точная структура | Точные ячейки | CER таблиц | Структура, мс |
|---|---|---|---|---|
| TableFormer V1 Accurate | 14/14 | 381/400 | 0.87 % | 210 |
| SLANeXt + RT-DETR | 12/14 | 312/400 | 3.34 % | 69 |
| TATR v1.1-all | 12/14 | 311/400 | 3.58 % | 78 |
| TableFormer V1 Fast | 13/14 | 338/400 | 13.04 % | 140 |
| SLANet_plus | 12/14 | 264/400 | 14.59 % | 26 |
| TableFormer V2 | 11/14 | 270/400 | 15.16 % | 166 |
Время — только предсказание структуры на одной вырезке после прогрева, среднее трёх повторов, RTX 3090. Без повторяющихся изображений порядок тот же: TableFormer V1 Accurate 10/10 структур и 303/320 ячеек.
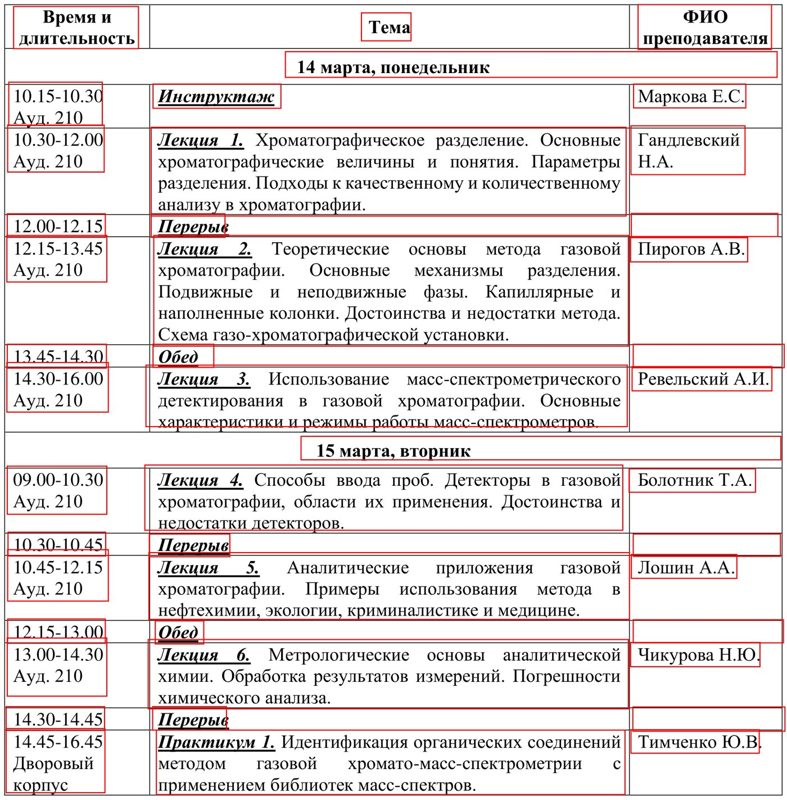
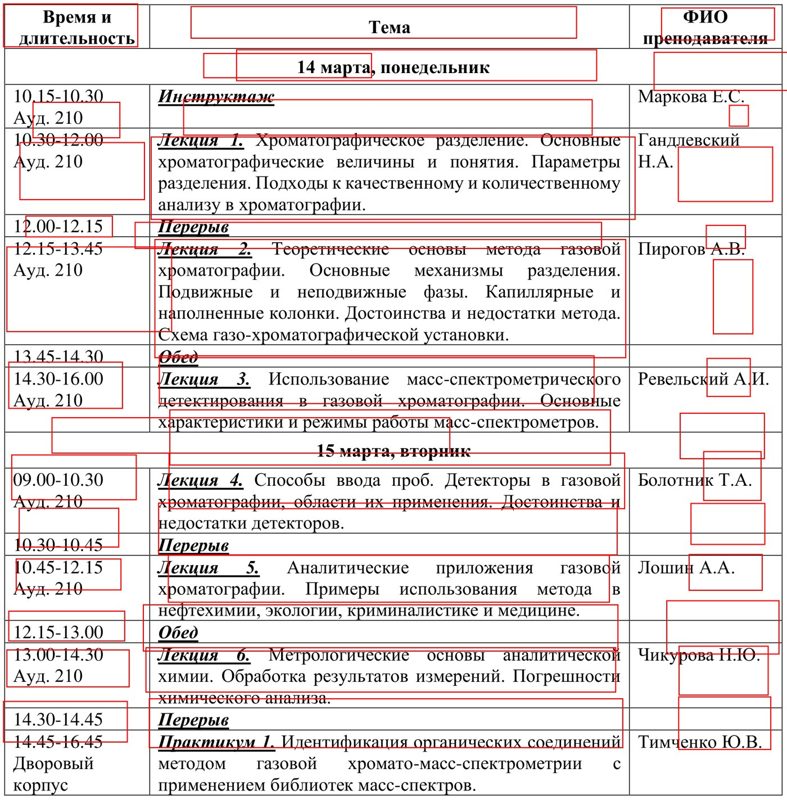
Новая TableFormer V2 оказалась хуже первой версии. Прежний выбор, SLANeXt, втрое быстрее, но ошибается на сложных таблицах с объединениями.
Читать каждую ячейку отдельно не стоит. Если распознавать каждую ячейку заново, а не раскладывать общий OCR по рамкам, точных ячеек у SLANeXt становится чуть больше (317 вместо 312), но растут и ошибки в символах, и время.
Слепой арбитр
Спорные таблицы показывали Qwen3.8-27B вместе с картинкой и вариантами разных моделей под буквами, без названий. Арбитр полезен как сигнал «здесь что-то не так»: на расписании МГУ он верно нашёл, что все четыре варианта первой серии теряют строку «15 марта», обед и перерыв. Но в итоговую разметку его ответы автоматически не попадают — у самого арбитра тоже бывают ошибки.
Полный каскад
Схема: электронный текст или PaddleOCR → PP-DocLayoutV3 → TableFormer V1 Accurate → Qwen только для спорных областей. Qwen вызывается, если есть текст, не попавший в ячейки, если уверенность layout ниже 0.8 или если у строки OCR уверенность ниже 0.9. По умолчанию — не больше 8 областей на документ.
| Вариант | CER документа | Точные ячейки |
|---|---|---|
| Быстрая основа: электронный текст + PaddleOCR | 16.60 % | 239/400 |
| Surya OCR 2 отдельно | 14.56 % | 289/400 |
| Каскад + Qwen + геометрия | 5.93 % | 400/400 |
| Каскад с TableFormer V1 | 9.73 % | 385/400 |
| Прежний полный конвейер | 0.50 % | 400/400 |
Текст внутри таблиц у каскада с TableFormer почти точный (CER 0.90 %), а ошибка всего документа складывается из текста и порядка чтения вне таблиц. Прежний конвейер на этом корпусе по-прежнему лучше всех, но он намного медленнее: 2686 секунд на 42 страницы против 35 секунд у быстрой основы (условия запуска разные).
Время этапов
- Быстрая основа: 0.85 с на страницу, включая запуск Paddle.
- Восстановление структуры всех таблиц: 2.4 с на весь корпус.
- Surya OCR 2: 5.0 с на страницу, с холодным запуском.
- Qwen: 39 с на одну спорную область, включая переключение модели. Поэтому дорогая ветка должна быть редкой.
Итог
- Для сетки таблиц брать TableFormer V1 Accurate. Если важна скорость — SLANeXt + RT-DETR.
- Распознавать текст один раз на всю страницу и раскладывать по ячейкам.
- LLM — только для спорных областей и только как кандидат на проверку.
- Корпус маленький и использовался при разработке. Для настоящей оценки нужна отложенная выборка размеченных таблиц: в плане 300 таблиц, из них 180 из русской финансовой отчётности.