Что такое Jev
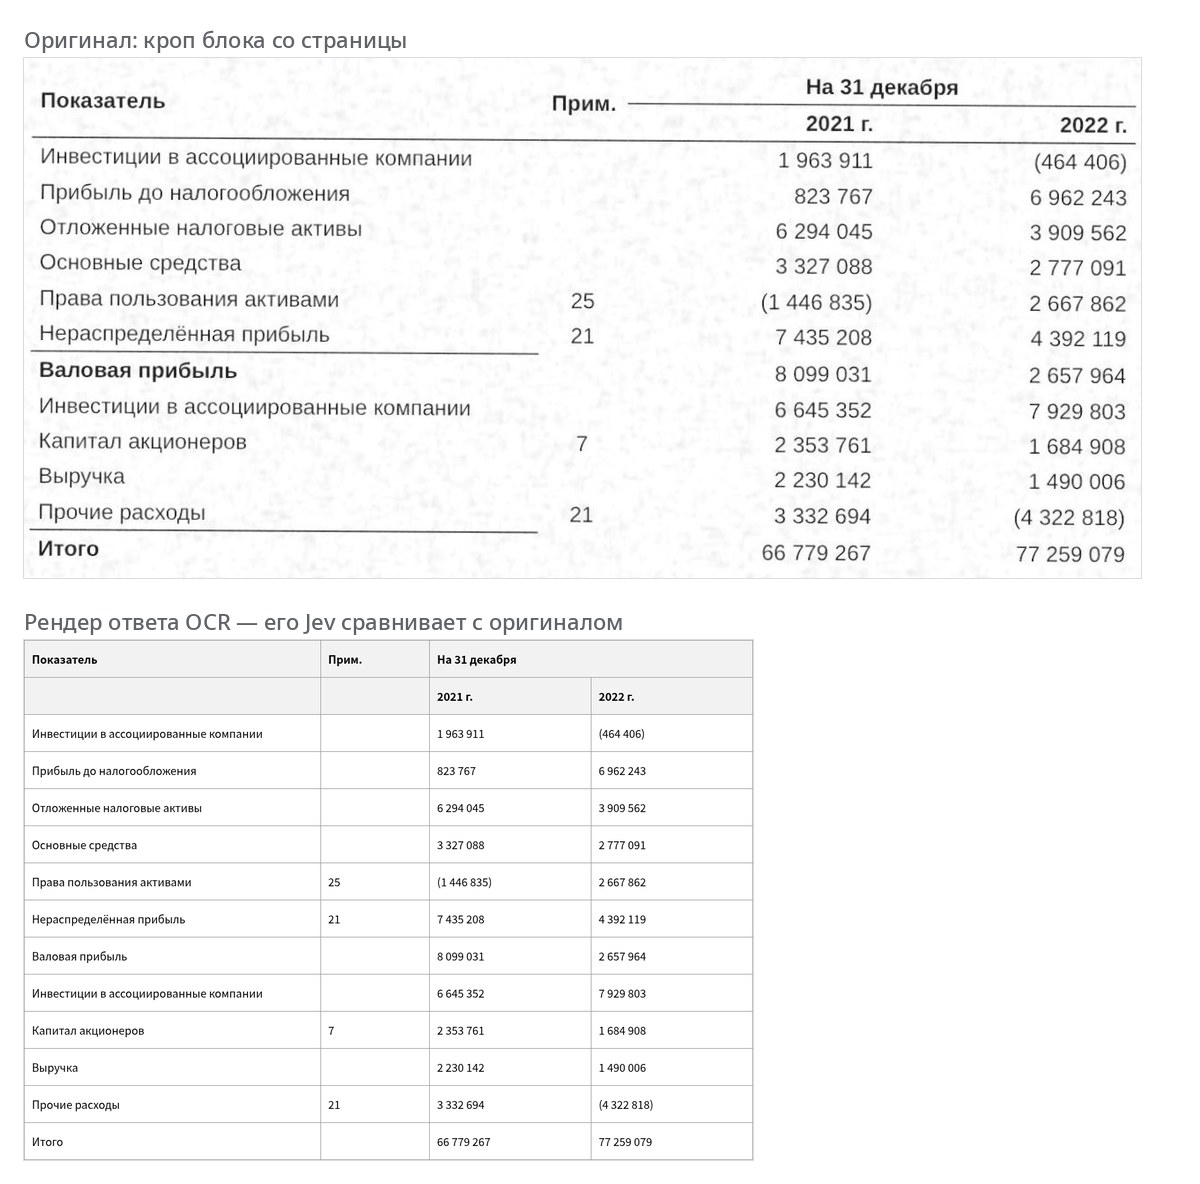
MiniCPM-OCR Jev вышел в октябре 2026 года вместе с распознавателем MiniCPM-OCR 1.0. Это Qwen3.5-2B, у которого вместо генерации стоит голова на два класса: «ответ OCR верен» и «неверен». На вход подаются три вещи:
- кроп блока со страницы (текст, формула или таблица);
- текст, который выдал распознаватель;
- рендер этого текста: сервис рисует его в Chromium (таблицы — как HTML, формулы — через KaTeX) и показывает модели вторую картинку.
На выходе вероятность от 0 до 1. Дальше два сценария: порог (выше — принимаем, ниже — на ручную проверку) и выбор лучшего из нескольких распознавателей для одного блока. Авторы заявляют AUROC 93.6 на своём китайско-английском бенче JevOCRBench. AUROC — вероятность того, что случайный верный блок получит оценку выше случайного неверного. Это не доля безошибочно распознанных страниц.
Из устройства сразу следует одно ограничение: Jev сравнивает картинки. Если OCR написал латинскую x (U+0078) вместо кириллической х (U+0445) или латинскую B вместо кириллической В, рендер не отличается от оригинала, и модель этого не увидит ни при каком дообучении. Такие ошибки надо ловить постобработкой.
Набор: русские блоки с проверяемой разметкой
Блочной разметки у бенча MWS нет, поэтому набор собран из страниц, где эталон известен по построению. Это те же данные, что в дообучении LightOnOCR-3:
- синтетика docs2: 15 семейств документов (протоколы, чеки, справки, двухколоночные статьи), текст и рамки блоков сняты из DOM при рендере;
- электронные PDF: публичная отчётность (МСФО, вестники ЦБ), эталон из текстового слоя;
- таблицы: синтетические HTML-таблицы с объединёнными ячейками;
- письма: синтетика по шаблону делового письма;
- рукопись: страницы школьных тетрадей из датасета Sber, построчная разметка.
Кандидаты — настоящие ответы LightOnOCR-3 0.8B в режиме grounding: пять версий модели (база и четыре LoRA-итерации), то есть пять разных профилей ошибок. Каждый эталонный блок сопоставлен с ответным блоком с наибольшим IoU, при IoU < 0.7 пара выбрасывается: так отсекаются разрезанные и склеенные блоки, где «ошибка» относится к разметке, а не к распознаванию. Кроп берётся по эталонной рамке. Обучение и тест разделены по документу: страницы одного PDF или одной тетради целиком попадают по одну сторону.
Какую ошибку считать ошибкой
Первая версия метки («нормализованный текст совпал») дала странную картину: в синтетике docs2 Jev «пропускал» почти половину ошибок. Разбор глазами показал, что из 320 «ошибок» в тесте 252 — латинские двойники (3 x 63,00 против 3 х 63,00) и разница в конвенциях: разрядка «С Н А Ч А Л А», перенос «прод- конфиг», пробел перед точкой в эталоне тетрадей («голос .»), вид тире, маркер списка.
Поэтому основная метка мягкая: перед сравнением латинские двойники приводятся к кириллице, тире к одному виду, убираются маркеры списков и все пробелы. Склейку слов («исходныеданные») она тоже не считает ошибкой: для решения «отправлять ли блок человеку» это мелочь. Строгую метку тоже посчитали, она ниже.
После этого оставшиеся ошибки просмотрены выборочно по каждому источнику: это настоящие ошибки распознавания (дате → дату, Росстат → Ростат, ремонтно → ремонто, rowspan в шапке таблицы потерян). В одном семействе синтетики текст специально бессмысленный («коипзекб доктиейбов»), и на картинке он такой же, так что это проверка чтения не-слов, а не ошибка эталона.
Тест — 1875 блоков с 243 страниц, сбалансированных по источнику, версии OCR и метке. Ошибок по мягкой метке 300 (16 %).
Jev из коробки
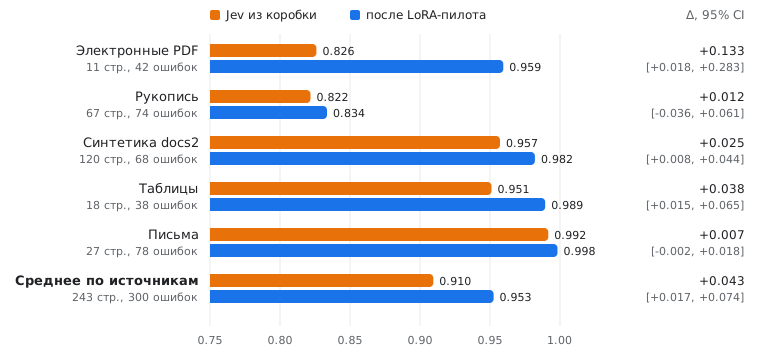
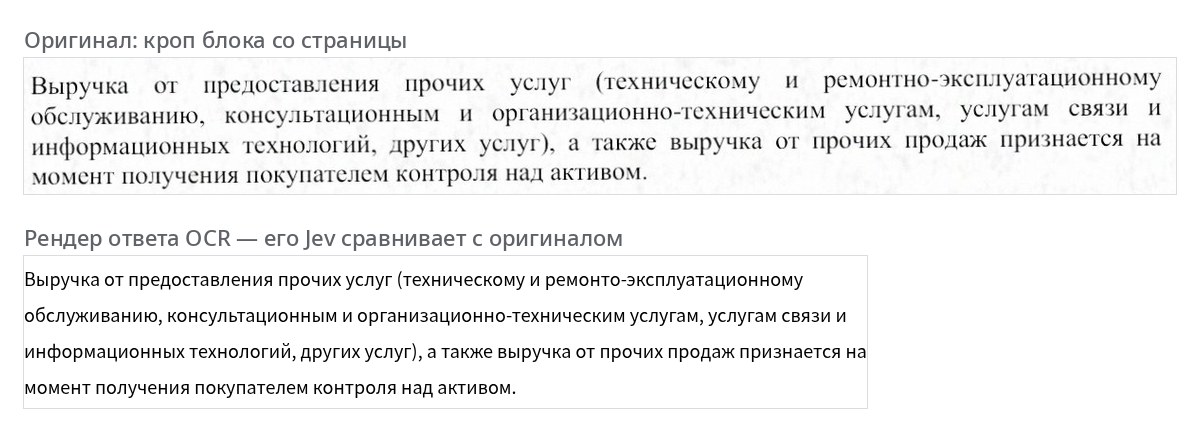
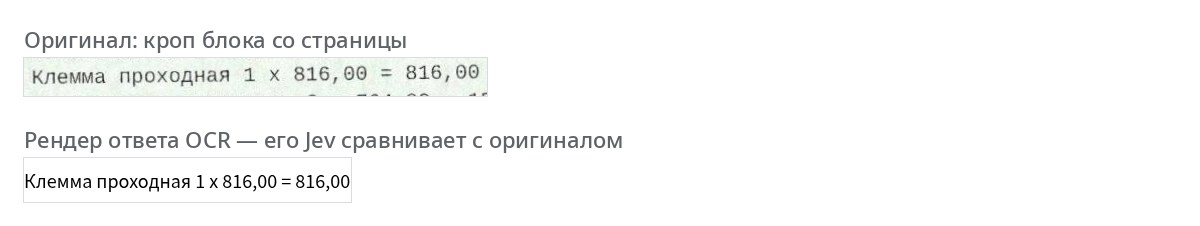
Из коробки среднее по источникам 0.910, ниже заявленных 93.6 на китайско-английском бенче. Синтетика, таблицы и письма — 0.95–0.99, но настоящие PDF (0.83) и рукопись (0.82) заметно хуже. Самые неприятные промахи — однобуквенные ошибки, которые модель уверенно (0.97–0.99) считает верными:
По строгой метке (латиница/кириллица и пробелы — ошибка) среднее 0.84, в синтетике docs2 0.74: почти все пропуски там — двойники.
Дообучение на одной RTX 3090
Авторский рецепт — полное дообучение на 8×A100 80 ГБ через ms-swift. На 24 ГБ так нельзя, поэтому:
- LoRA r=16 на всех линейных слоях языковой части (16.8 млн параметров, 0.75 %), визуальный энкодер заморожен, голова классификатора обучается целиком;
- промпт, процессор и проверка последнего токена взяты из вендорского
eval/score.py— обучение и оценка видят байт-в-байт один вход; - 6165 примеров: 2970 настоящих ответов LightOnOCR-3 (сбалансированы по источнику, версии и метке) и 3195 синтетических — эталонный текст как верный пример плюс его порча как неверный (похожие буквы ш/щ, и/й, о/0, цифра в сумме, пропущенное или удвоенное слово, пустая ячейка таблицы). Метка синтетики верна по построению;
- одна эпоха, микробатч 8 × накопление 2, lr 1e-4, gradient checkpointing. 42 минуты, пик 22.3 ГБ.
Результат на тех же 1875 тестовых блоках тем же скриптом оценки: среднее по источникам 0.910 → 0.953, +0.043 [+0.017, +0.074]. Больше всего выросли настоящие PDF: 0.826 → 0.959. Интервал широкий, потому что в тесте всего 11 страниц PDF, но он целиком выше нуля.
Что это даёт на практике
Тот же результат в единицах работы: сколько блоков отправить человеку, чтобы поймать заданную долю ошибок. Блоки сортируются по оценке, проверяются самые сомнительные.
| поймать 80 % ошибок | 90 % | 95 % | |
|---|---|---|---|
| печатные блоки, Jev из коробки | 18 % блоков | 25 % | 38 % |
| печатные блоки, после дообучения | 12 % | 15 % | 17 % |
| рукопись, из коробки | 57 % | 72 % | 86 % |
| рукопись, после дообучения | 58 % | 70 % | 79 % |
Доля ошибок в тесте — 13 % у печатных и 46 % у рукописных блоков. На другой доле ошибок проценты будут другими, но соотношение между моделями сохранится.
Рукопись не поддаётся
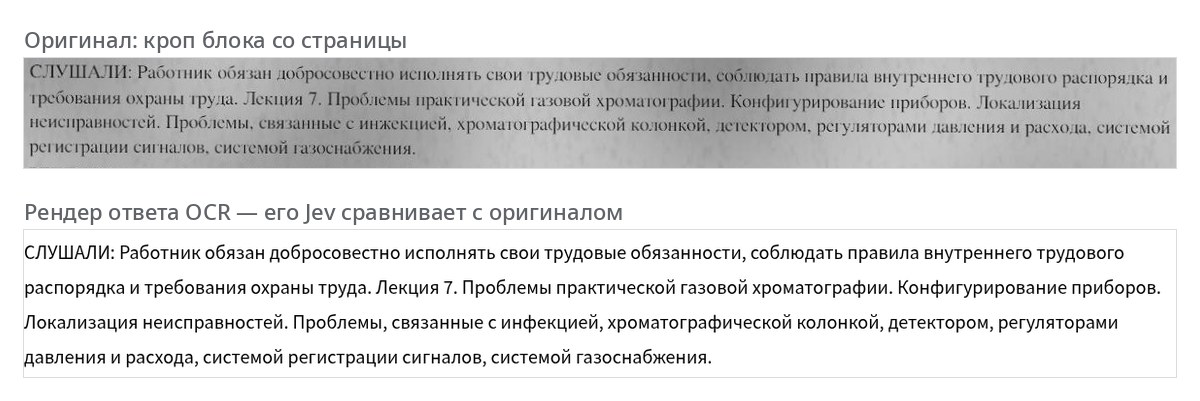
На тетрадях прирост +0.012 [−0.036, +0.061] — интервал включает ноль, прироста не измерено. При этом изменилось поведение на отдельных блоках, и не всегда в лучшую сторону:
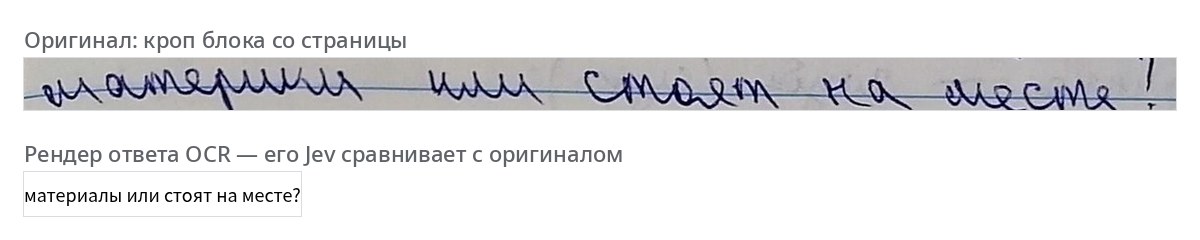
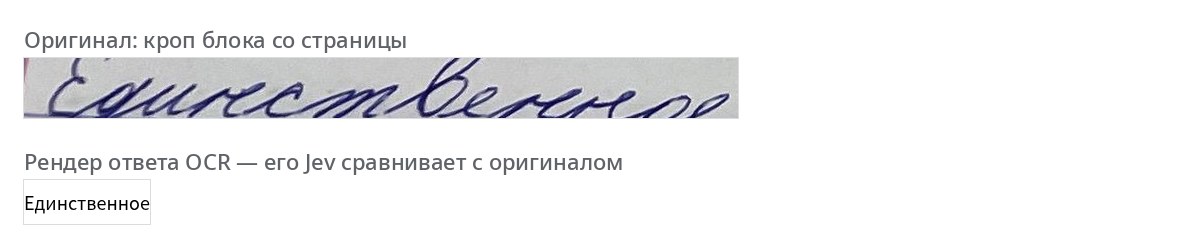
Синтетическая порча учит модель замечать подмену букв в печатном тексте, где начертание однозначно. В рукописи «материки» и «материалы» действительно похожи, и чтобы различать их, модели нужны настоящие ошибки на почерке, а не синтетика. Тот же вывод получился в дообучении LightOnOCR-3: почерку учат только живые тетради.
Блок или страница целиком
Jev оценивает тот кусок, который ему дали. Сколько таких кусков на странице, зависит от того, как распознаватель режет её на блоки. LightOnOCR-3 на 120 настоящих страницах MWS выделяет:
| страницы | блоков на странице, медиана | 10–90 % страниц |
|---|---|---|
| печатные (90) | 16 | 8–30 |
| рукописные (30) | 7 | 3–14 |
В пересчёте на страницы сервис из раздела «Скорость» ниже (31 блок/с) — это около 2 печатных страниц в секунду. Если отправить все блоки страницы одновременно, вердикт по странице готов примерно за 0.8 с. Сам LightOnOCR-3 на той же карте распознаёт ~2.5–3 страницы в секунду, так что на общей видеокарте проверка займёт примерно столько же времени, сколько распознавание (это оценка — вместе их не гоняли).
Отсюда вопрос: а нельзя ли подавать крупнее — всю таблицу, всю страницу?
Чем крупнее блок, тем хуже
Таблица и так подаётся целиком: в тесте каждая таблица — один блок. Но качество зависит от размера. Те же 1875 тестовых блоков с настоящими ошибками OCR, только печатные:
| размер блока | блоков | ошибок | из коробки | после дообучения |
|---|---|---|---|---|
| текст до 100 символов | 1104 | 73 | 0.993 | 0.998 |
| 100–300 символов | 251 | 36 | 0.938 | 0.974 |
| 300–700 символов | 123 | 31 | 0.877 | 0.927 |
| 700+ символов | 48 | 34 | 0.849 | 0.952 |
| таблица 40–80 ячеек | 102 | 20 | 0.999 | 1.000 |
| таблица 80+ ячеек | 53 | 15 | 0.884 | 0.937 |
Ответ у модели один на весь вход: одна неверная буква в абзаце из 700 символов — несколько пикселей из сотен тысяч. Дообучение сокращает разрыв, но не убирает его. (Маленькие таблицы до 40 ячеек — 0.86 / 0.88 — выбиваются из ряда, но их всего 34 и причину не разбирали.)
Целая страница
Чтобы сравнить честно, на каждой из 261 тестовой страницы взяли одну и ту же ошибку и подали её двумя способами. Один случайный блок страницы испорчен одной правкой — так же, как в синтетике для обучения: похожая буква, цифра, пропущенное слово, ячейка таблицы.
- блок: кроп блока + его эталон (верный) или испорченный эталон (неверный);
- страница: вся страница + эталонный текст всех её блоков подряд (верный) или тот же текст с той же порчей (неверный).
Метки верны по построению, отличается только размер входа.
| блок | страница | |
|---|---|---|
| AUROC, из коробки | 0.948 | 0.768 |
| AUROC, после дообучения | 0.983 | 0.850 |
| верных принято при пороге 0.5, из коробки | 71 % | 34 % |
| верных принято при пороге 0.5, после дообучения | 85 % | 38 % |
| неверных отбраковано при пороге 0.5, из коробки | 97 % | 97 % |
Разница «блок − страница» из коробки +0.180 [+0.157, +0.204], после дообучения +0.133 [+0.109, +0.157] (парный бутстрап по страницам). Порча здесь того же рода, что в обучающей синтетике, поэтому абсолютные цифры дообученной версии в этой таблице завышены; сравнение блока со страницей от этого не зависит.
Ошибки на странице модель по-прежнему отбраковывает — проблема в том, что она отбраковывает и верные страницы. Рендер не воспроизводит вёрстку: сервис рисует текст сплошным потоком, и страница из двух колонок с заголовком превращается в одну широкую колонку. Модель видит две непохожие картинки и отвечает «не совпадает».
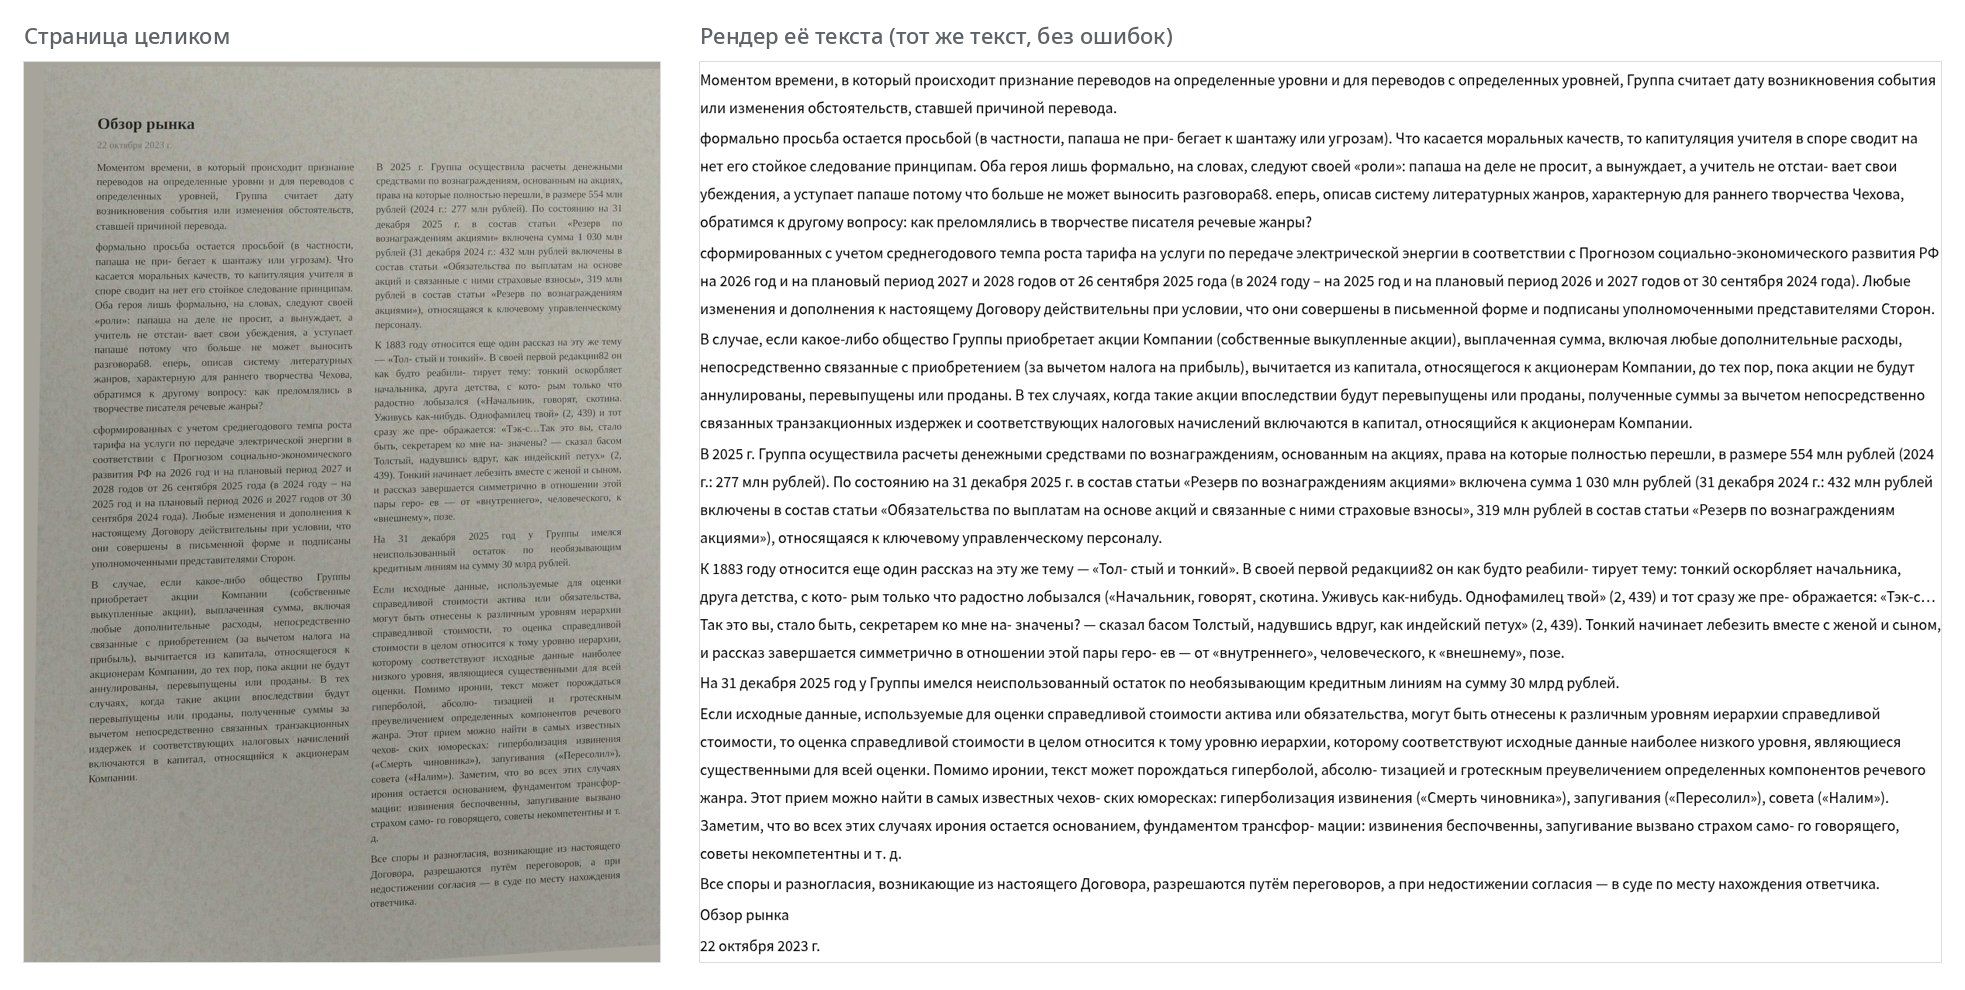
Хуже всего с рукописью: из 75 верных страниц тетрадей ни одна не набрала 0.5 ни до, ни после дообучения. Исключение — страницы, где почти всё место занимает одна таблица (0.975 по блоку против 0.991 по странице): там страница по сути и есть один блок.
Вывод: подавать нужно блоки, а большие — дробить: таблицу больше ~80 ячеек — по частям вместе с шапкой, длинный абзац — по строкам. К тому же блочная оценка говорит человеку, какой именно кусок перечитать, а страничная — только что где-то на странице есть ошибка.
Скорость
Сервис из официального Docker-образа: vLLM в режиме классификации плюс рендерер (2 браузера Chromium по 8 вкладок). RTX 3090 24 ГБ, лимит мощности 250 W, частота SM до 2100 МГц. Набор — 400 тестовых блоков, по одному блоку на запрос; каждая параллельность прогнана дважды (вверх и вниз по числу потоков), в таблице среднее, проходы расходятся меньше чем на 2 %.
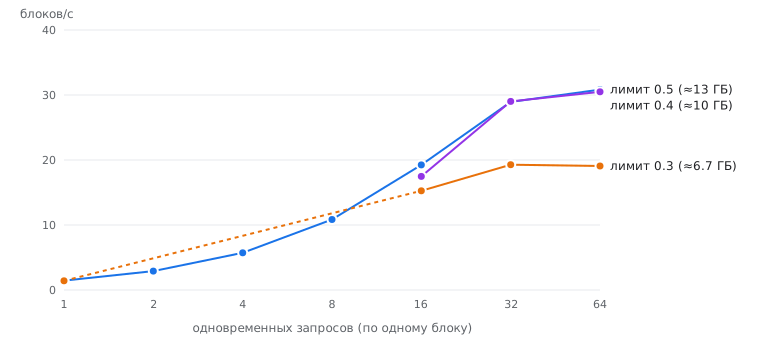
| одновременных запросов | 1 | 4 | 16 | 32 | 64 |
|---|---|---|---|---|---|
| с рендером, блоков/с | 1.4 | 5.7 | 19.2 | 28.9 | 30.8 |
| с рендером, задержка p50 / p95, с | 0.67 / 0.8–1.0 | 0.68 / 0.84 | 0.78 / 1.04 | 1.0 / 1.55 | 1.8 / 2.9 |
| только модель, блоков/с | 10.1 | 27.5 | 38.1 | 38.0 | 37.8 |
| только модель, задержка p50, с | 0.09 | 0.13 | 0.38 | 0.80 | 1.57 |
Лимит памяти vLLM 0.5. «Только модель» — тот же сервис, но рендер передан готовым (поле render_image).
Что из этого следует:
- Одиночный запрос на 85 % — рендер. Из 0.67 с сама модель занимает 0.09 с, остальное — Chromium. Если нужна низкая задержка, рендер надо держать прогретым или делать заранее.
- Параллельность работает почти линейно до 16 запросов, потолок ~31 блок/с с 32–64 запросами. Без рендера модель упирается в ~38 блоков/с уже на 16 запросах: при высокой нагрузке узкое место — видеокарта, рендер отстаёт ненамного.
- Для сравнения, тот же Jev через transformers без vLLM (вендорский
score.py, готовые рендеры) — 5.4–5.8 блока/с, в 6–7 раз медленнее. - Скорость дообученной версии не мерили отдельно: архитектура и размер те же.
Видеопамять
| режим | видеопамять | скорость |
|---|---|---|
| vLLM, лимит 0.5 (по умолчанию в образе 0.8) | 12.8–13.2 ГБ | 31 блок/с |
| vLLM, лимит 0.4 | 9.5–10.3 ГБ | 30 блоков/с |
| vLLM, лимит 0.3 | 6.6–6.7 ГБ | 19 блоков/с |
| transformers, батч 1 | 5.1 ГБ | 5.4 блока/с |
| transformers, батч 4 | 7.8 ГБ (резерв 9.8) | 5.8 блока/с |
| обучение LoRA, микробатч 1 | 7.7 ГБ | 0.7 примера/с |
| обучение LoRA, микробатч 8 | 22.3 ГБ | 2.4 примера/с |
vLLM — по nvidia-smi во время прогонов, за вычетом рабочего стола; transformers и обучение — пик PyTorch. Из бюджета vLLM 4.3 ГБ занимают веса и служебная память, ~2 ГБ — пиковые активации, остальное — KV-кэш. Блоку нужно ~600 токенов (медиана 260, максимум 7.5 тыс. у больших таблиц). При лимите 0.4 кэша хватает на 220 тыс. токенов, и скорость та же, что при 0.5. При 0.3 кэш 54 тыс. токенов, и потолок падает до 19 блоков/с. Разумный минимум для сервиса — ~10 ГБ.
Обучение без gradient checkpointing на микробатче 8 в 24 ГБ не влезает. С checkpointing 4 % микробатчей (самые длинные таблицы) всё равно упали по памяти и были пропущены — в скрипте это уже исправлено повтором по одному примеру.
Что развернуть и где споткнулись
- Официальный образ собирается из
scripts/minicpm-ocr-jev/serve/Dockerfile, 23.6 ГБ: vLLM, Chromium, KaTeX и шрифты Noto CJK. В Noto CJK есть кириллица, рендер русского текста и таблиц проверен глазами. - Документация показывает
imageкакdata:image/png;base64,..., но сервис ждёт голый base64: с префиксом каждый блок возвращается сencode_error. Перед использованием оценки надо смотретьverdict:0.0и-1.0— это коды сбоя, а не низкая уверенность. - Рендер внутри контейнера работает только от root: Chromium лежит в
/root/.cache. - Оценки сервиса и вендорского
score.pyчерез transformers совпадают: среднее 0.885 и 0.884 на старой версии метки, медианная разница вероятностей 0.001. Поэтому дообученную модель можно сравнивать скриптом без пересборки образа. - Быстрые ядра Qwen3.5 (flash-linear-attention + causal-conv1d) на обучении оказались медленнее штатного пути (0.20 против 0.71 примера/с): triton перекомпилирует их под каждую новую длину последовательности. Ускорили батчами по 8 с выравниванием по длине: 2.4 примера/с.
Ограничения
- Обучение запускалось один раз. Бутстрап учитывает разброс тестовой выборки, но не разброс между запусками обучения.
- В синтетике, таблицах и письмах одни и те же семейства шаблонов есть и в обучении, и в тесте, поэтому прирост там оптимистичен. Честнее всего PDF — другие документы, — но их в тесте 11 страниц.
- Кандидаты — только от LightOnOCR-3. Как Jev оценивает ответы других распознавателей на русском, не проверено.
- На реальных сканах блочной разметки нет, перенос на них не измерен.
- Доли «сколько отправить на проверку» посчитаны на тесте с 16 % ошибок; при другой доле они другие.
Итог
Для печатных русских документов Jev стоит брать как фильтр перед ручной проверкой, причём сразу с дообучением: 42 минуты на одной RTX 3090 на собственных проверяемых данных сокращают долю блоков для проверки с 25 % до 15 % при том же числе пойманных ошибок. Латиницу вместо кириллицы он не увидит по устройству — её ловить отдельно. Для рукописи Jev не годится ни из коробки, ни после такого дообучения: нужны настоящие ошибки на почерке. Сервис на vLLM держит ~30 блоков/с при ~10 ГБ видеопамяти; одиночный запрос — 0.67 с, из которых большая часть уходит на рендер.