Выбор по операциям
| Операция | Брать | Почему | Запасной вариант |
|---|---|---|---|
| Текст | PyMuPDF get_text() (mupdf-rs, если код на Rust) |
330–425 страниц в секунду на ядро, 2 сбоя из 44 проблемных файлов, F1 0.974 и порядок 0.986 — на уровне лучших | pypdfium2: на 10–20 % быстрее, 31 МБ против 157, но 8 сбоев из 44 |
| Сигналы для OCR | PyMuPDF в том же проходе | единственный с полным набором сигналов, включая шрифты без ToUnicode; время ×2.5 к извлечению текста | pypdfium2: ×1.6, без проверки ToUnicode |
| Таблицы | PyMuPDF find_tables() |
11 страниц в секунду, 0 сбоев, тот же движок | pdfplumber: 10 страниц в секунду, меньше памяти |
| Изображения | PyMuPDF extract_image() |
24 страницы в секунду на сканах, 0 сбоев, JPEG и JPX без перекодирования | pdfium-render: 52 страницы в секунду, но 8 сбоев |
| Рендер 200 DPI | pypdfium2 | 4.9 страницы в секунду на ядро, 41 на 16 процессах, пик 271 МБ против 1246 у PyMuPDF | PyMuPDF: 4.4 страницы в секунду, меньше сбоев |
Извлечение текста
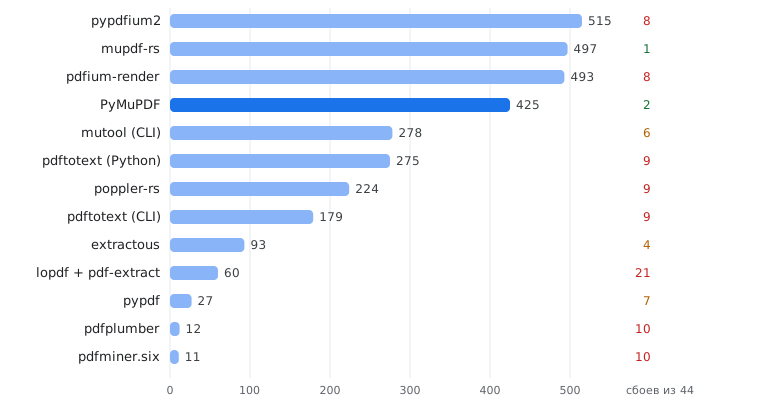
Тройка лидеров по скорости — обёртки над pdfium и mupdf-rs, около 500 страниц в секунду. PyMuPDF чуть медленнее (425), но падает всего на 2 проблемных файлах из 44, а pdfium — на 8. На отчётности с таблицами разница исчезает: PyMuPDF 331 страница в секунду, pypdfium2 316.
Pure-Python парсеры (pypdf, pdfplumber, pdfminer.six) в 15–40 раз медленнее и падают чаще. pdf-rs показал 1366 страниц в секунду, но вне зачёта: декодер текста для него пришлось написать вручную, и он теряет 13–17 % символов.
Качество и порядок чтения
48 страниц из 30 документов: 16 статей arXiv (10 в две колонки) и 32 местных документа (отчётность с таблицами, прайсы, схемы). Эталон — распознавание отрисованной страницы моделью LightOnOCR-3, независимое от текстового слоя и проверенное глазами на 5 случайных страницах. Порядок — доля 4-грамм слов эталона, идущих в правильной последовательности.
| Метод | F1 по словам | Порядок | Порядок, 2 колонки | Страниц в секунду |
|---|---|---|---|---|
PyMuPDF get_text() |
0.974 | 0.986 | 0.958 | 89 |
| pdftotext (поток) | 0.974 | 0.933 | 0.884 | 142 |
| pdfminer | 0.973 | 0.981 | 0.935 | 9 |
| extractous | 0.971 | 0.986 | 0.958 | 14 |
| pypdfium2 | 0.966 | 0.986 | 0.958 | 142 |
| pypdf | 0.960 | 0.985 | 0.957 | 13 |
| pymupdf4llm + layout | 0.941 | 0.988 | 0.968 | 0.2 |
| pymupdf4llm | 0.895 | 0.992 | 0.986 | 6 |
| pdfplumber | 0.824 | 0.902 | 0.834 | 6 |
PyMuPDF sort=True |
0.966 | 0.817 | 0.751 | 46 |
pdftotext -layout |
0.966 | 0.814 | 0.748 | 149 |
Что из этого следует:
- Порядок из потока PDF почти идеален. LaTeX и Word пишут текст в порядке чтения. Ошибки бывают, когда генератор писал блоки вразнобой: например, в прайс-листе нижняя таблица в файле идёт первой.
- Сортировка по координатам вредит.
sort=Trueиpdftotext -layoutсшивают строки соседних колонок, порядок на двухколоночных страницах падает до 0.75. - pymupdf4llm лучше всех по порядку, но без разметки страницы выбрасывает текст внутри векторных схем, а с разметкой — формулы. И работает медленно: 6 и 0.2 страницы в секунду.
- pypdfium2 отстаёт на 0.01 F1 только из-за переносов: перенос в конце строки он отдаёт служебным символом, и слово не склеивается. Это чинится одной заменой.
Таблицы
41 документ отчётности, 1941 страница.
| Библиотека | Страниц в секунду | Пик памяти, МБ | Сбои |
|---|---|---|---|
| Camelot stream | 19.4 | 158 / 532 | 8 из 41 |
PyMuPDF find_tables() |
11.0 | 157 / 227 | 0 из 41 |
| pdfplumber | 10.1 | 51 / 148 | 0 из 41 |
| img2table | 3.6 | 609 / 3967 | 2 из 41 |
| Camelot lattice | 3.5 | 294 / 460 | 8 из 41 |
Все 8 сбоев Camelot — файлы с запретом извлечения текста: их отклоняет pdfminer внутри Camelot.
Рендер и изображения
Рендер в 200 DPI на 100 сканах (2371 страница): pypdfium2 и pdfium-render — 4.9 страницы в секунду на ядро, PyMuPDF — 4.4, poppler — 3.7–3.9. На 16 процессах pdfium даёт 41 страницу в секунду при пике памяти 271 МБ, PyMuPDF — 37 при 1246 МБ.
Извлечение изображений сравнимо только при одинаковом результате. Требованию «JPEG и JPX как есть, CCITT, JBIG2 и Flate декодировать» отвечают mupdf-rs (61 страница в секунду), pdfium-render (52), PyMuPDF (24) и pypdfium2 (5).
Память на больших документах
На документах от 500 страниц (стандарт Unicode на 1140 страниц, скан с OCR-слоем, скан JBIG2/JPX) и на 1000 документах подряд в одном процессе утечек нет у mupdf-rs, PyMuPDF и pdfium. У extractous память растёт: 350 → 578 МБ.
Оговорки
- Хост был нагружен (vLLM и около 45 контейнеров), поэтому разница меньше 10 % — в пределах шума.
- Холодный старт — свежий процесс, файл выброшен из кеша страниц.
- docling-parse исключён: около 6 страниц в секунду.
- Сканы — с pravo.gov.ru (69), archive.org (24) и локальные (7).
- Версии: PyMuPDF и mutool 1.28.2, pypdfium2 5.14 и pdfium-render 0.8.37 (pdfium chromium/8076), Poppler 25.03, pdfplumber 0.11.10, pypdf 6.21, mupdf-rs 0.5.