Задача
Из больших файлов Excel (до сотен тысяч строк) нужно достать данные локальными моделями. Схема:
- Лист режется на блоки: таблица, блок «поле: значение», текст, мусор.
- По каждой таблице строится короткая карточка, около тысячи токенов даже на 200 тысяч строк.
- Агент по карточкам пишет карту: какая таблица нужна, какие столбцы, какие строки пропускать.
- Карта компилируется в загрузку в DuckDB.
Эта статья — про первый шаг. На рабочих документах почти всегда есть одна основная таблица. Поэтому главная метрика — нашли ли основную таблицу, а не точность по всем блокам листа.
Данные
- DECO — 854 реальных листа из корпуса Enron с ручной разметкой регионов. Публичный набор из репозитория Mondrian.
- Синтетика «РСБУ/МСФО» — свой генератор: баланс, отчёт о финансовых результатах и движении денежных средств, оборотно-сальдовая ведомость, план-факт, таблицы бок о бок и вплотную друг под другом, реквизиты, подписи, мусор вроде «СВЕРИТЬ». 64 листа, 144 таблицы, плюс две ОСВ на 50 и 200 тысяч строк для замеров скорости.
Разметка DECO была испорчена. Координаты регионов в файле аннотаций не совпадали с реальными диапазонами на 259 листах, а на 104 строки были сдвинуты или сжаты. Правильные диапазоны лежали рядом, в названиях регионов (Table_A20_F38). Ошибка нашлась при просмотре листов глазами. Все цифры, посчитанные до исправления, выброшены, ниже только результаты по исправленной разметке. Ещё 131 лист DECO входит в обучающий набор ExcelTableCNN — для честного сравнения они исключены.
Гибрид: граф ячеек и два классификатора
- Граф. Каждая непустая ячейка соединяется с ближайшей непустой справа и снизу, в том числе через 1–3 пустые строки или столбца. Так в граф попадают и «дырявые» таблицы, и границы между соседними таблицами.
- Классификатор связей (LightGBM, 54 признака, только значения ячеек, без стилей) оценивает, принадлежат ли две ячейки одной таблице. Признаки: типы ячеек и соседей, длина текста, объединения, «Итого/Всего», прогоны ячеек по строке и столбцу, плотность и доля чисел в окне ±10 строк.
- Сборка. Сначала ячейки объединяются по уверенным связям, потом группы склеиваются по средней вероятности связей между ними. Простые связные компоненты по порогу проваливались: одна ошибочная связь сшивала две таблицы в цепочку.
- Классификатор блоков отделяет таблицы от реквизитов, подписей и заметок.
- Правила раскладки поверх гибрида исправляют типовые случаи: повтор шапки, таблицы вплотную.
Результаты
| Метод | DECO, все таблицы | Синтетика | Скорость |
|---|---|---|---|
| Связные компоненты с зазором | ~0.47 | — | мгновенно |
| LLM Qwen по сжатой кодировке листа | 0.42 (подвыборка) | 0.835 | 18–27 с на лист |
| Гибрид | 0.63 | 0.747 | 4 мс на лист |
| Гибрид + правила | 0.65 | 0.845 | ≈ гибрид |
| ExcelTableCNN (Faster R-CNN по признакам ячеек) | 0.66 | 0.960 | ~90 мс на лист |
F1 по таблицам: таблица найдена, если IoU по непустым ячейкам не меньше 0.8.
Основная таблица (гибрид + правила):
| Набор | Найдена | Найдена первой | Точно (IoU ≥ 0.95) |
|---|---|---|---|
| DECO | 0.86 | 0.84 | 0.71 |
| Синтетика | 0.95 | 0.83 | 0.75 |
Где ошибается
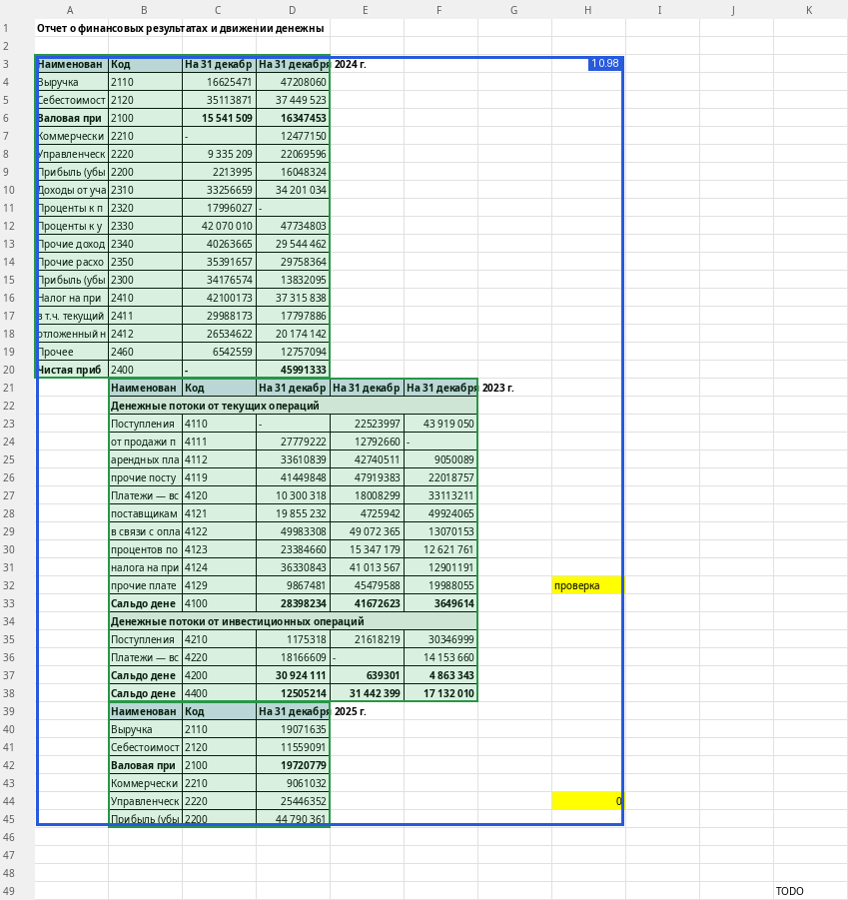
Около 20 % промахов по основной таблице — к ней приклеено лишнее: чаще сбоку, реже снизу и сверху. Остальное — обрезанная таблица или выбрана не та таблица.
У ExcelTableCNN другая слабость — длинные таблицы. Он лучше гибрида на таблицах до 30 строк, но таблицы длиннее 300 строк режет на перекрывающиеся куски: находит 25 % таких таблиц против 81 % у гибрида.
Что не сработало
- LLM на весь лист. Лучший результат на синтетике, но 18–27 секунд на лист. Реальные огромные листы в контекст не помещаются.
- Синтетика в обучении ухудшила результат на DECO.
- LLM-арбитр на спорных блоках — +0.007, не стоит своих секунд.
- Признаки без контекста строки и прогона опускают качество до уровня простых связных компонент.
- Абсолютные счётчики строк и столбцов развалили ОСВ на 200 тысяч строк на 14 тысяч кусков. Признаки должны быть только локальными.
- Mondrian по качеству не лучше связных компонент с зазором, а медленнее в 300–1000 раз. Docling на ОСВ из 200 тысяч строк — 33 с и 5 ГБ памяти против 1.3 с у чтения через calamine со связными компонентами.
Дообучение под свои шаблоны
Если у пользователя есть размеченные листы, гибрид можно дообучить. Это помогает, только когда на один шаблон приходится два и больше документов (0.69 → 0.91). На невиданных шаблонах прироста нет.