Задача
Таблицы в отчётности (МСФО, отчёты ЦБ) лучше читать из текстового слоя PDF, чем через OCR: это быстрее и числа не теряются. Для этого нужен детектор, который отвечает на два вопроса: есть ли на странице таблица и какие у неё ячейки. Если детектор ложно видит таблицу там, где её нет, страница уходит по неверному пути. Поэтому главный критерий здесь — ложные срабатывания, а не только точность ячеек.
Данные и эталон
- 36 цифровых PDF-страниц с таблицами: отчётность МСФО (Азот, Химпром, РусНефть, Россети, ОЗОН, М.Видео, IFRS, и файлы HEAD и GCHE), отчёты ЦБ, препринты arXiv.
- Эталон — вывод LightOnOCR-3 на тех же страницах (на рисунках — правая колонка). Это не ручная разметка: на трёх страницах без таблиц (из десяти) и на страницах с таблицами, которые я смотрел, эталон верный, на отдельных страницах он спорный. Поэтому часть выводов ниже сделана по картинкам, а не по числам.
- Метрика — F1 по словам внутри таблиц, сравнение с эталоном. Она грубая:
find_tablesтеряет пробелы в ячейках (ЭкскурсионноеобслуживаниевКирилло), Camelot захватывает обычный текст страницы. Оба артефакта занижают F1. - Два прохода на одной машине (CPU), методы чередовались.
Результаты
| Критерий | PyMuPDF find_tables | Camelot stream | Camelot lattice |
|---|---|---|---|
| Ложные таблицы на страницах без таблиц (10 страниц) | 0 | 10 | 3 |
| PDF с запретом извлечения текста (7 страниц, все МСФО) | открываются | ошибка PDFTextExtractionNotAllowed |
ошибка PDFTextExtractionNotAllowed |
| Медиана F1, 25 страниц с таблицами в эталоне | 0.43 | 0.35 | 0.00 |
| Медиана F1, 36 страниц | 0.27 | 0.06 | 0.00 |
| Время на страницу (медиана) | ~430 мс | ~60 мс | ~200 мс |
Lattice на таблицах с линиями точен: F1 0.95–1.00 на 10 страницах (например, cbr, paper.pdf с таблицей 1, ОЗОН). Но большинство безлинейных таблиц МСФО он не находит вообще, поэтому медиана у него ноль.
Итог по измеренным числам: не брать Camelot ни в одном режиме как детектор таблиц. Stream даёт ложные таблицы на текстовых страницах, lattice их даёт меньше, но пропускает таблицы без линий. Оба падают на защищённых PDF.
Где Camelot ошибается
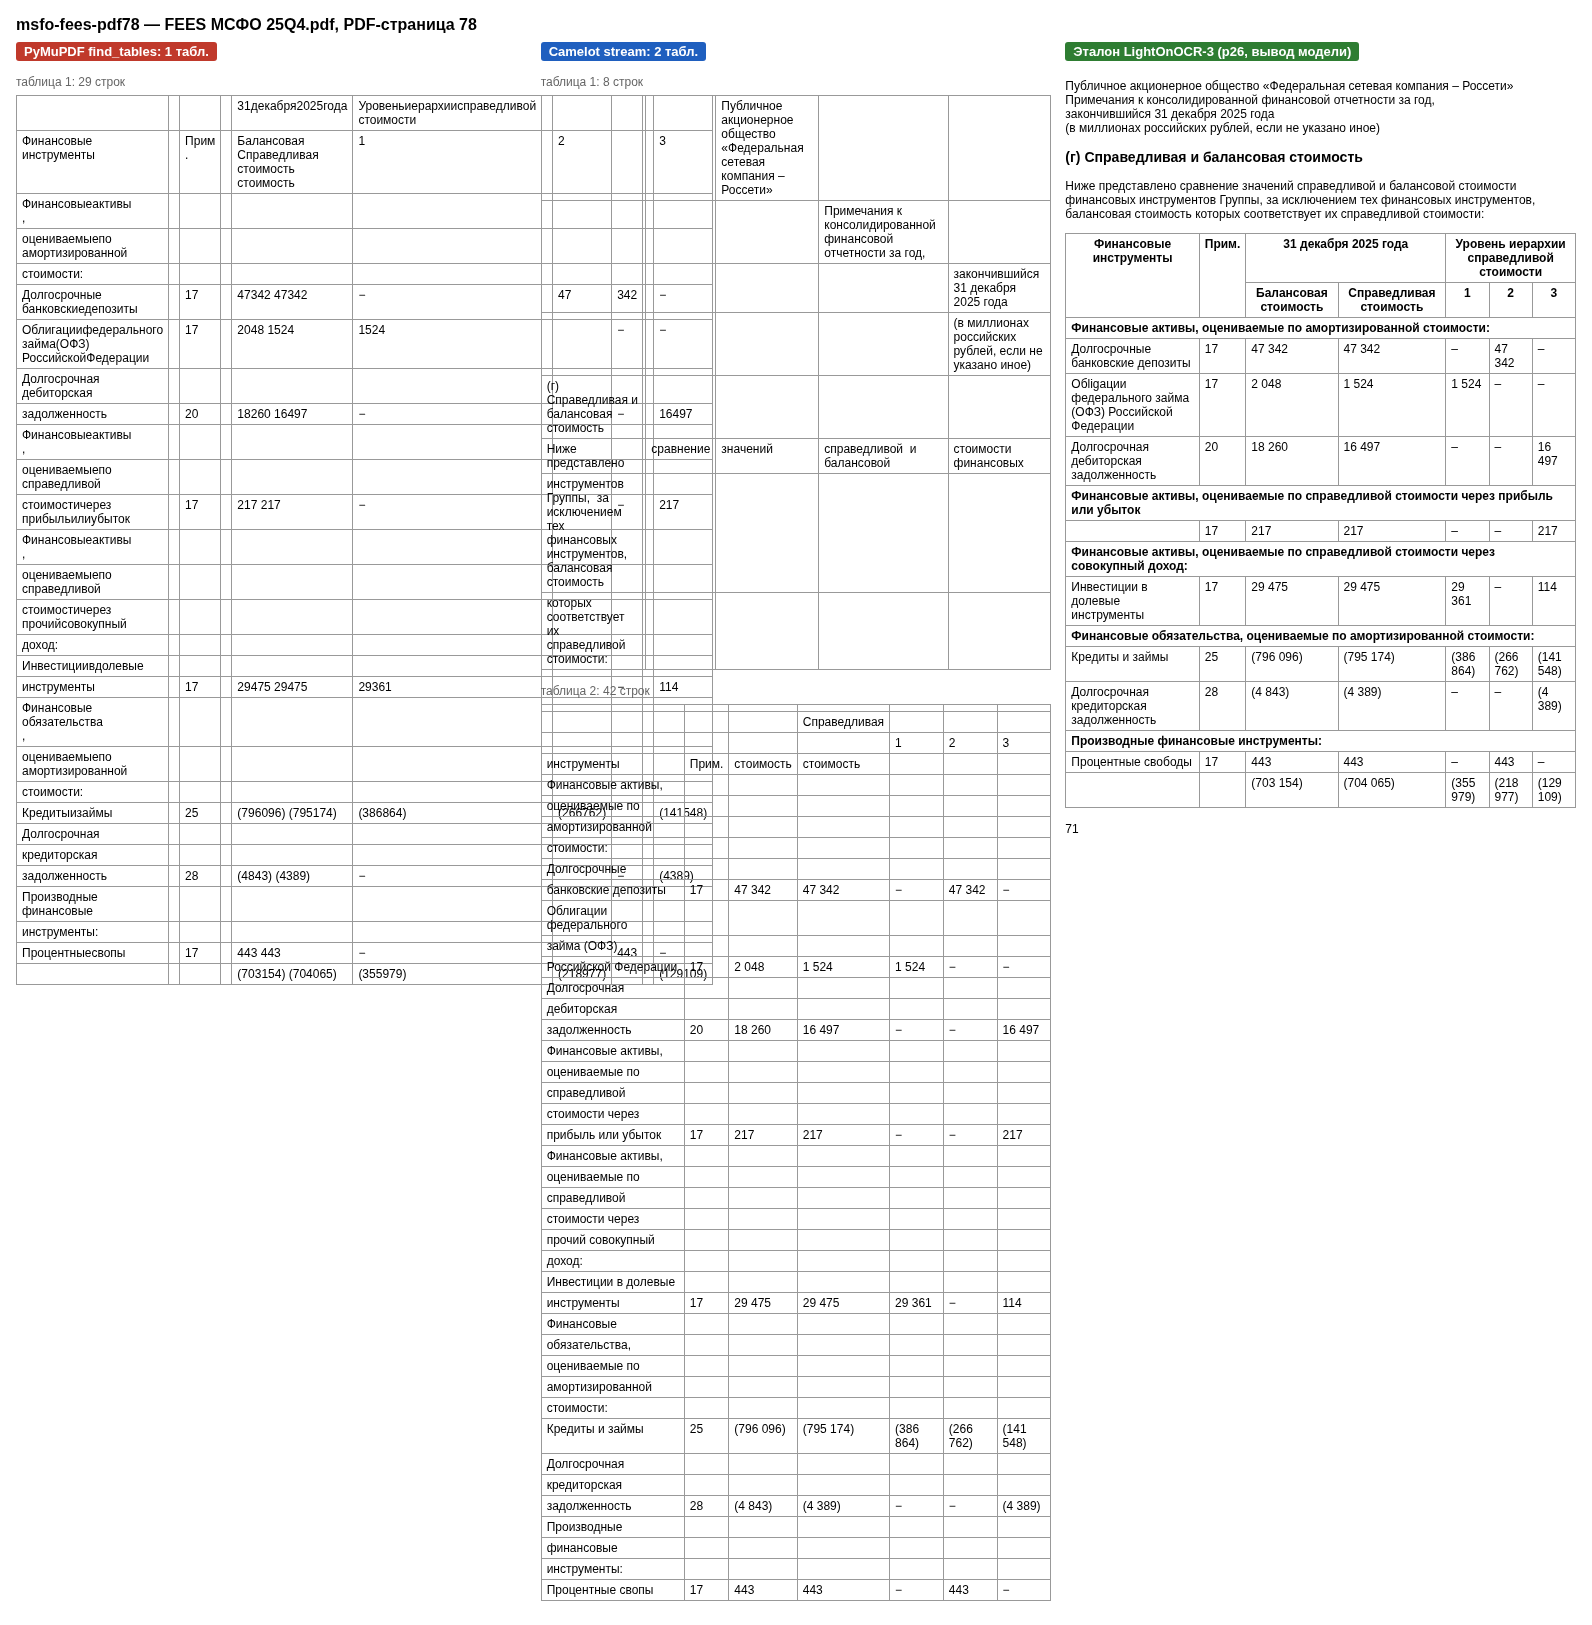
1. Ошибка на защищённых PDF. Семь страниц четырёх отчётов (HEAD, М.Видео, IFRS, GCHE) имеют запрет на извлечение текста. Camelot отказывается их открывать, PyMuPDF — нет. Это не редкость для корпоративной отчётности, поэтому Camelot нельзя ставить единственным путём.
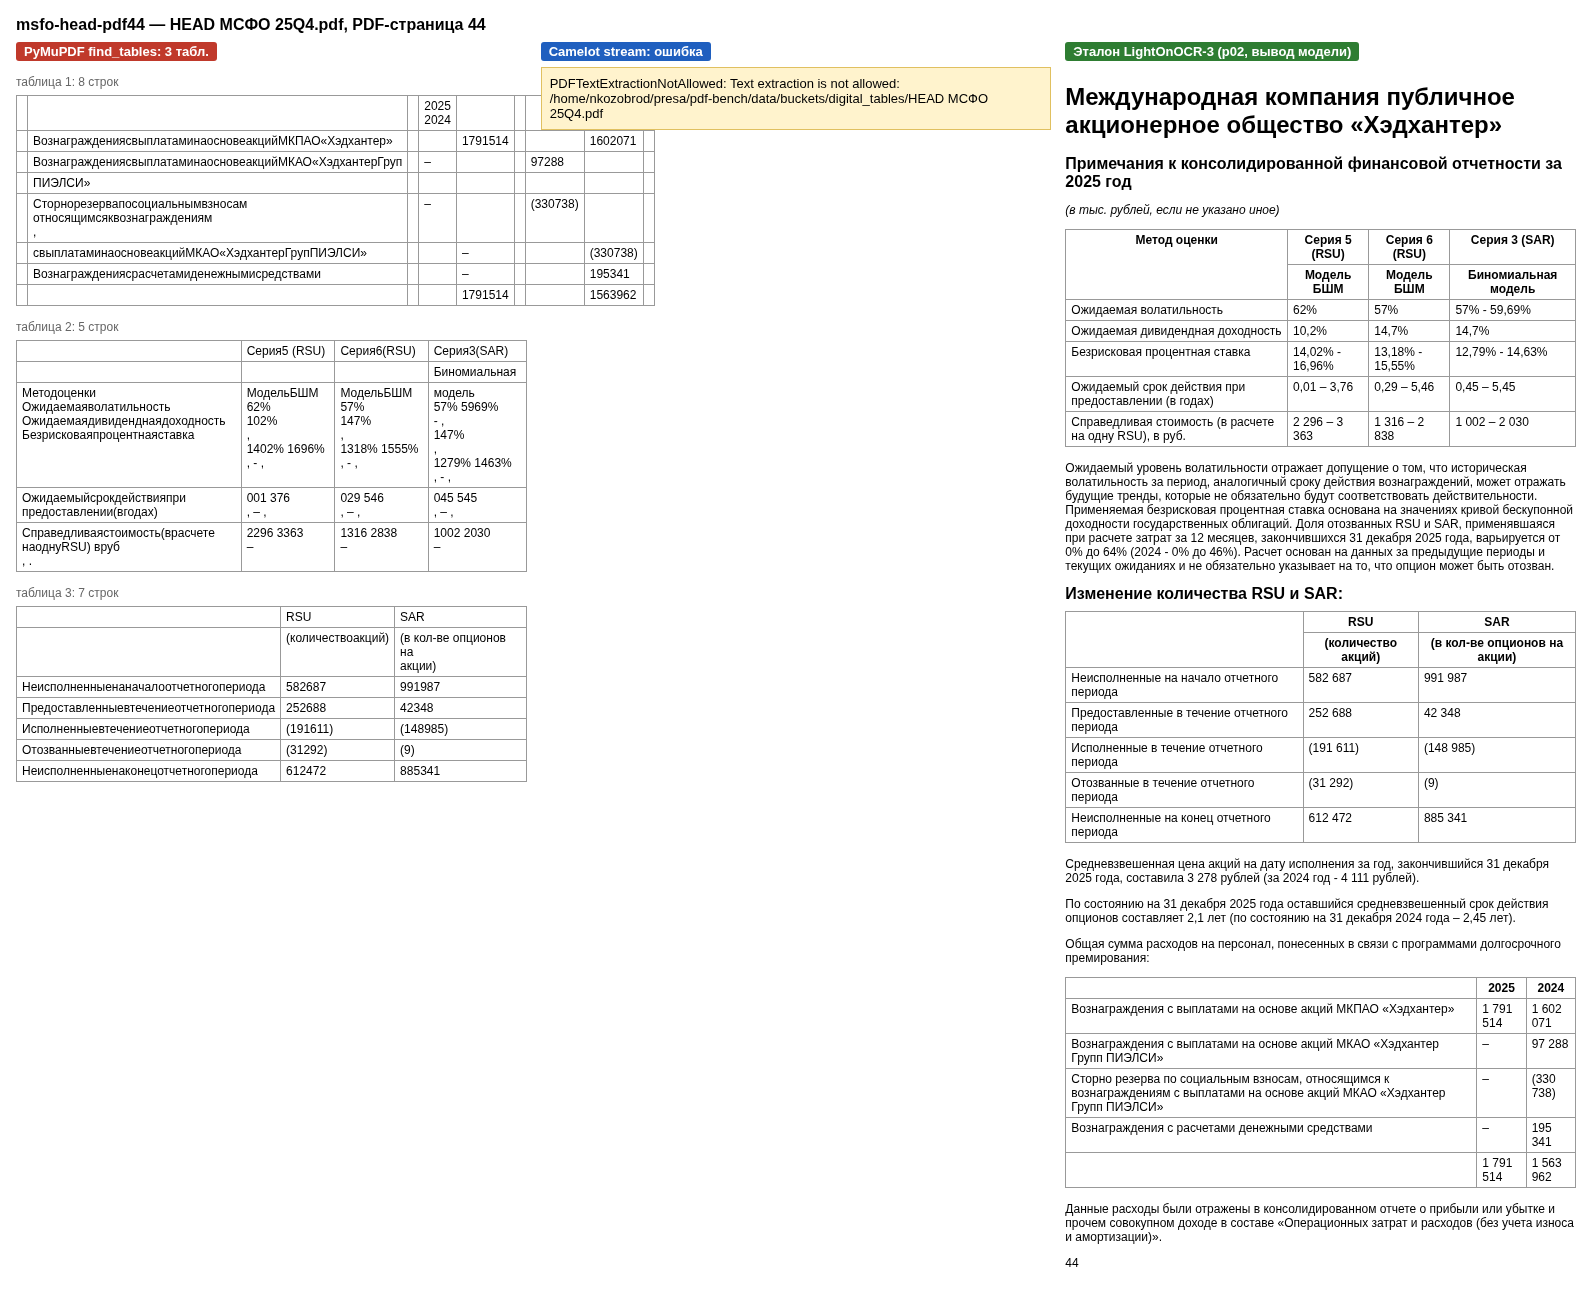
2. Текст страницы вместо таблицы. На странице 41 отчёта АО ГК «Азот» есть две мелкие таблицы, остальное — текст примечаний. Camelot принял весь текст страницы за таблицу (точность 0.19 при полноте 1.00).
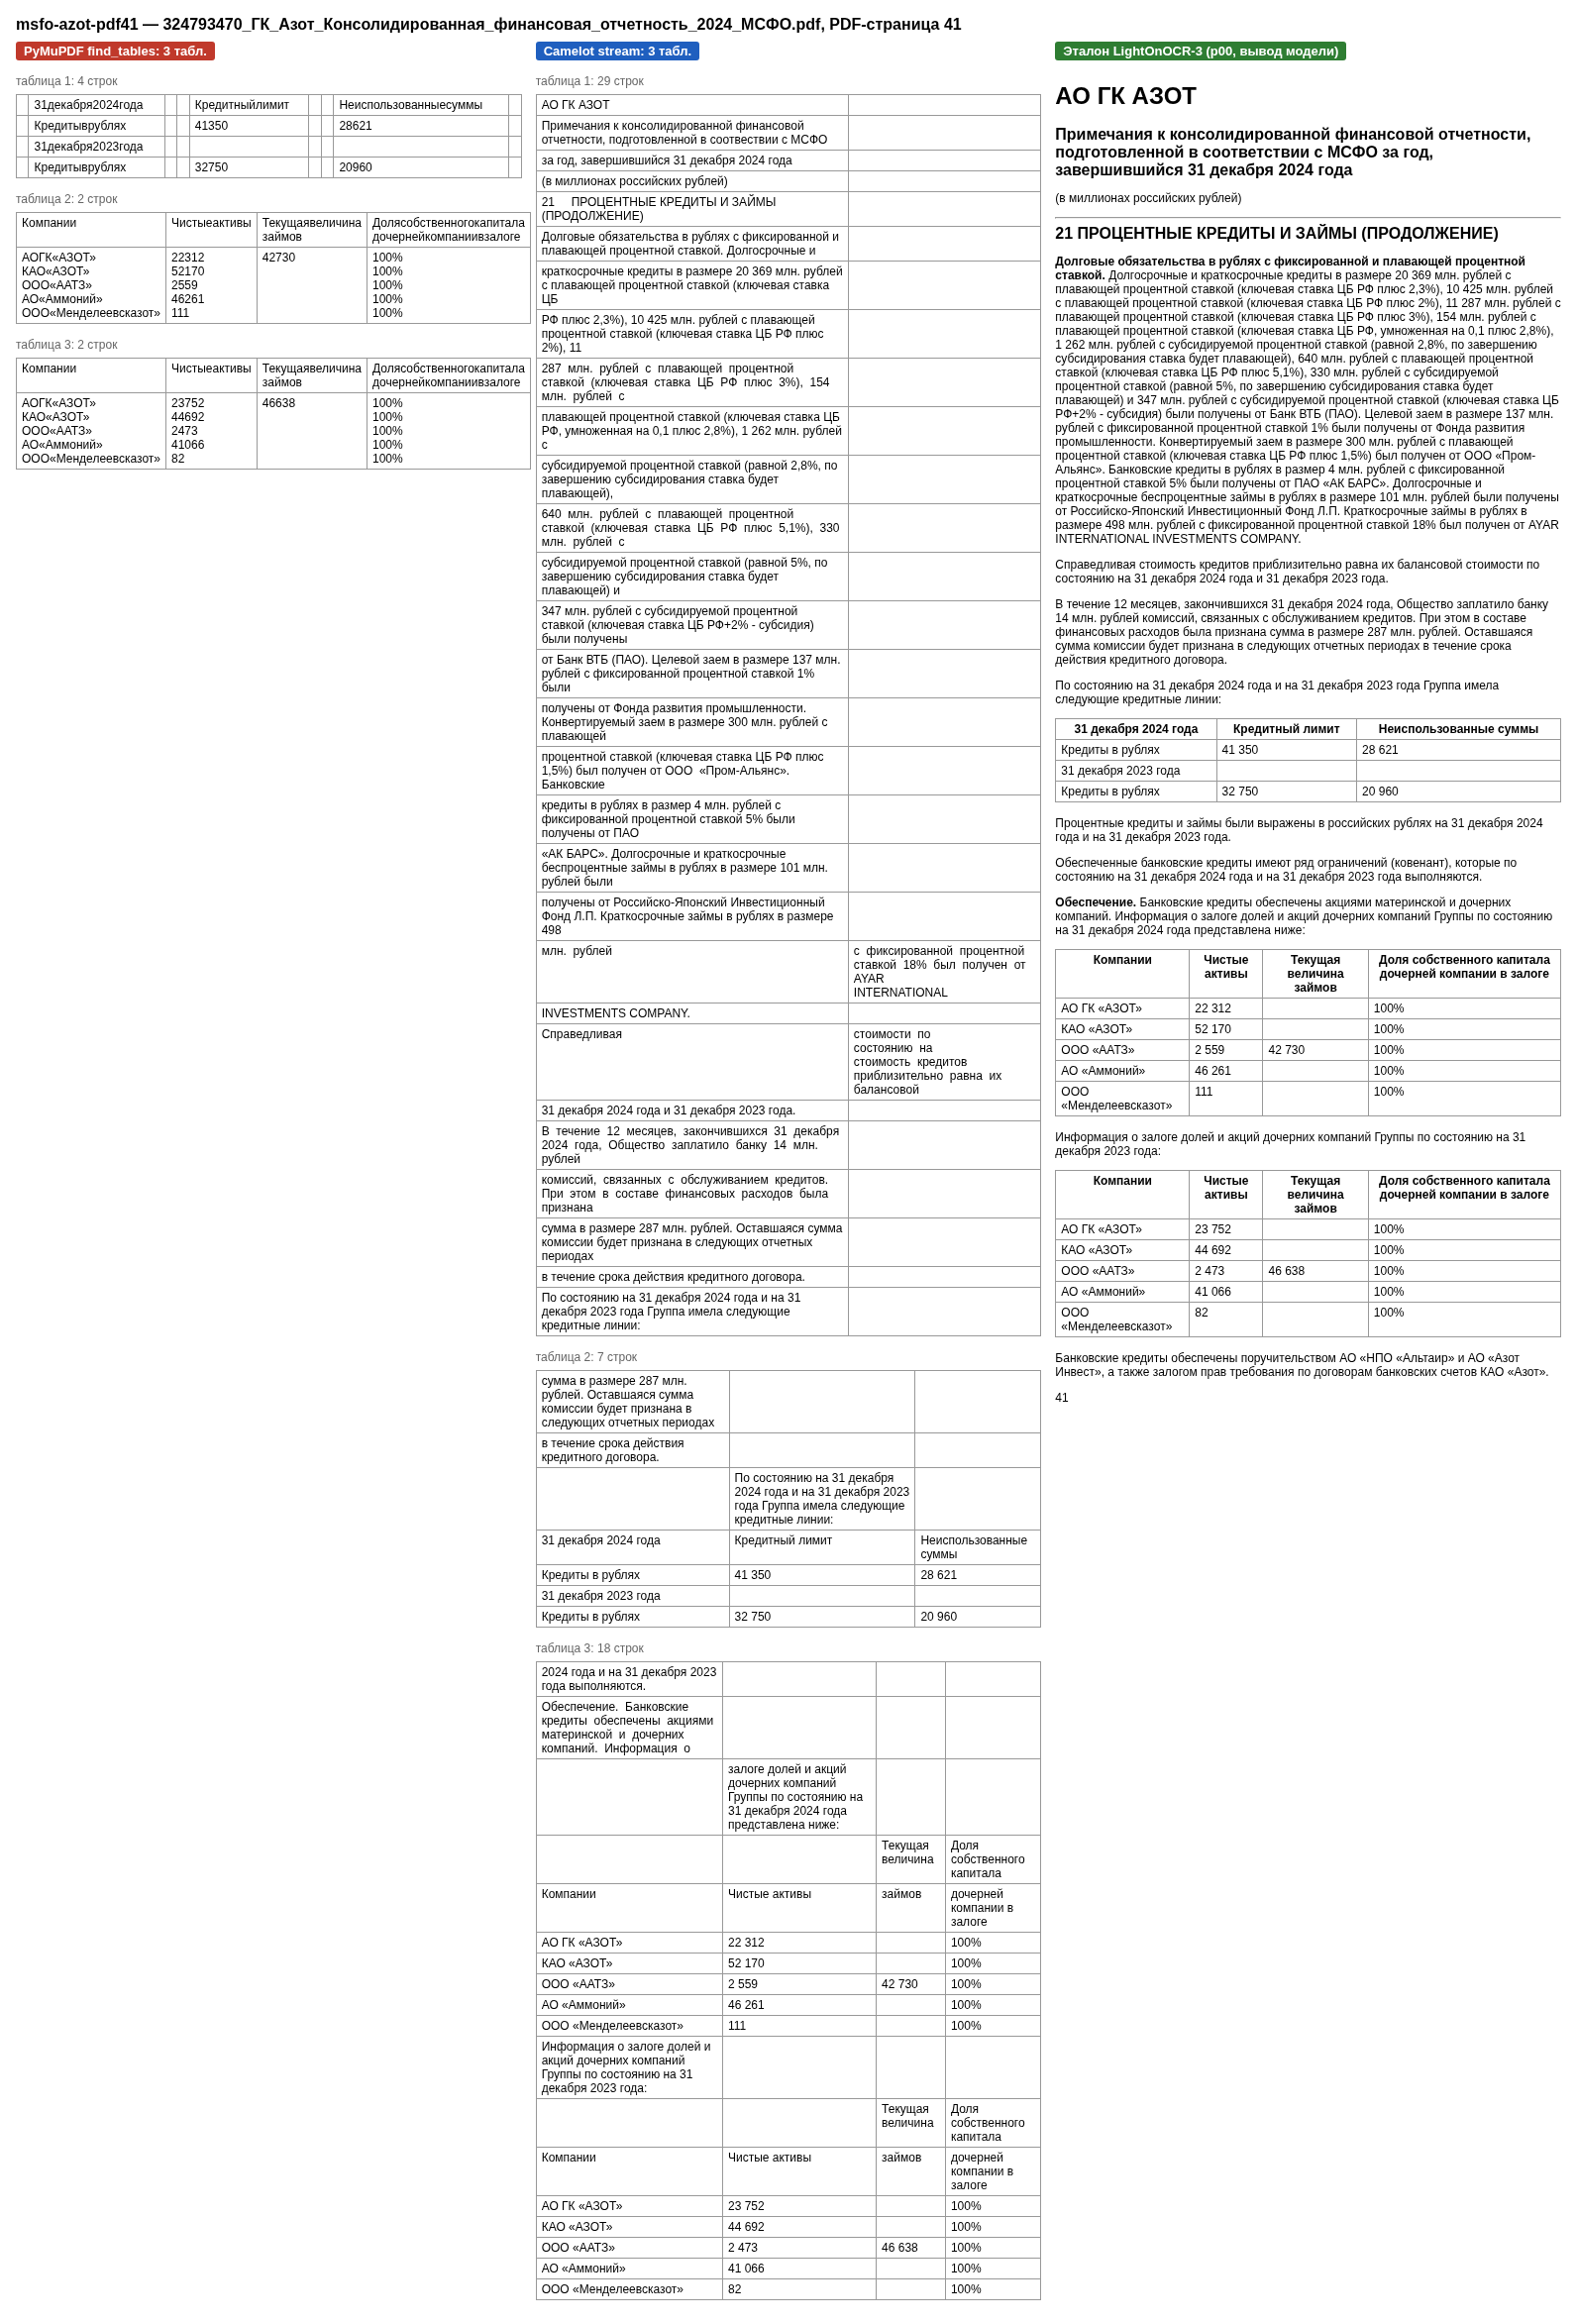
3. Таблицы без линий. На странице 64 отчёта «РусНефть» четыре таблицы без сетки. Camelot вернул две, и ячейки соседних таблиц в них перемешаны. Отдельные строки при этом читаются верно, например «Кредиты и займы полученные (90 374) (27 963) (44 849)». find_tables нашёл все четыре, но склеил слова, и F1 на странице 0.13.
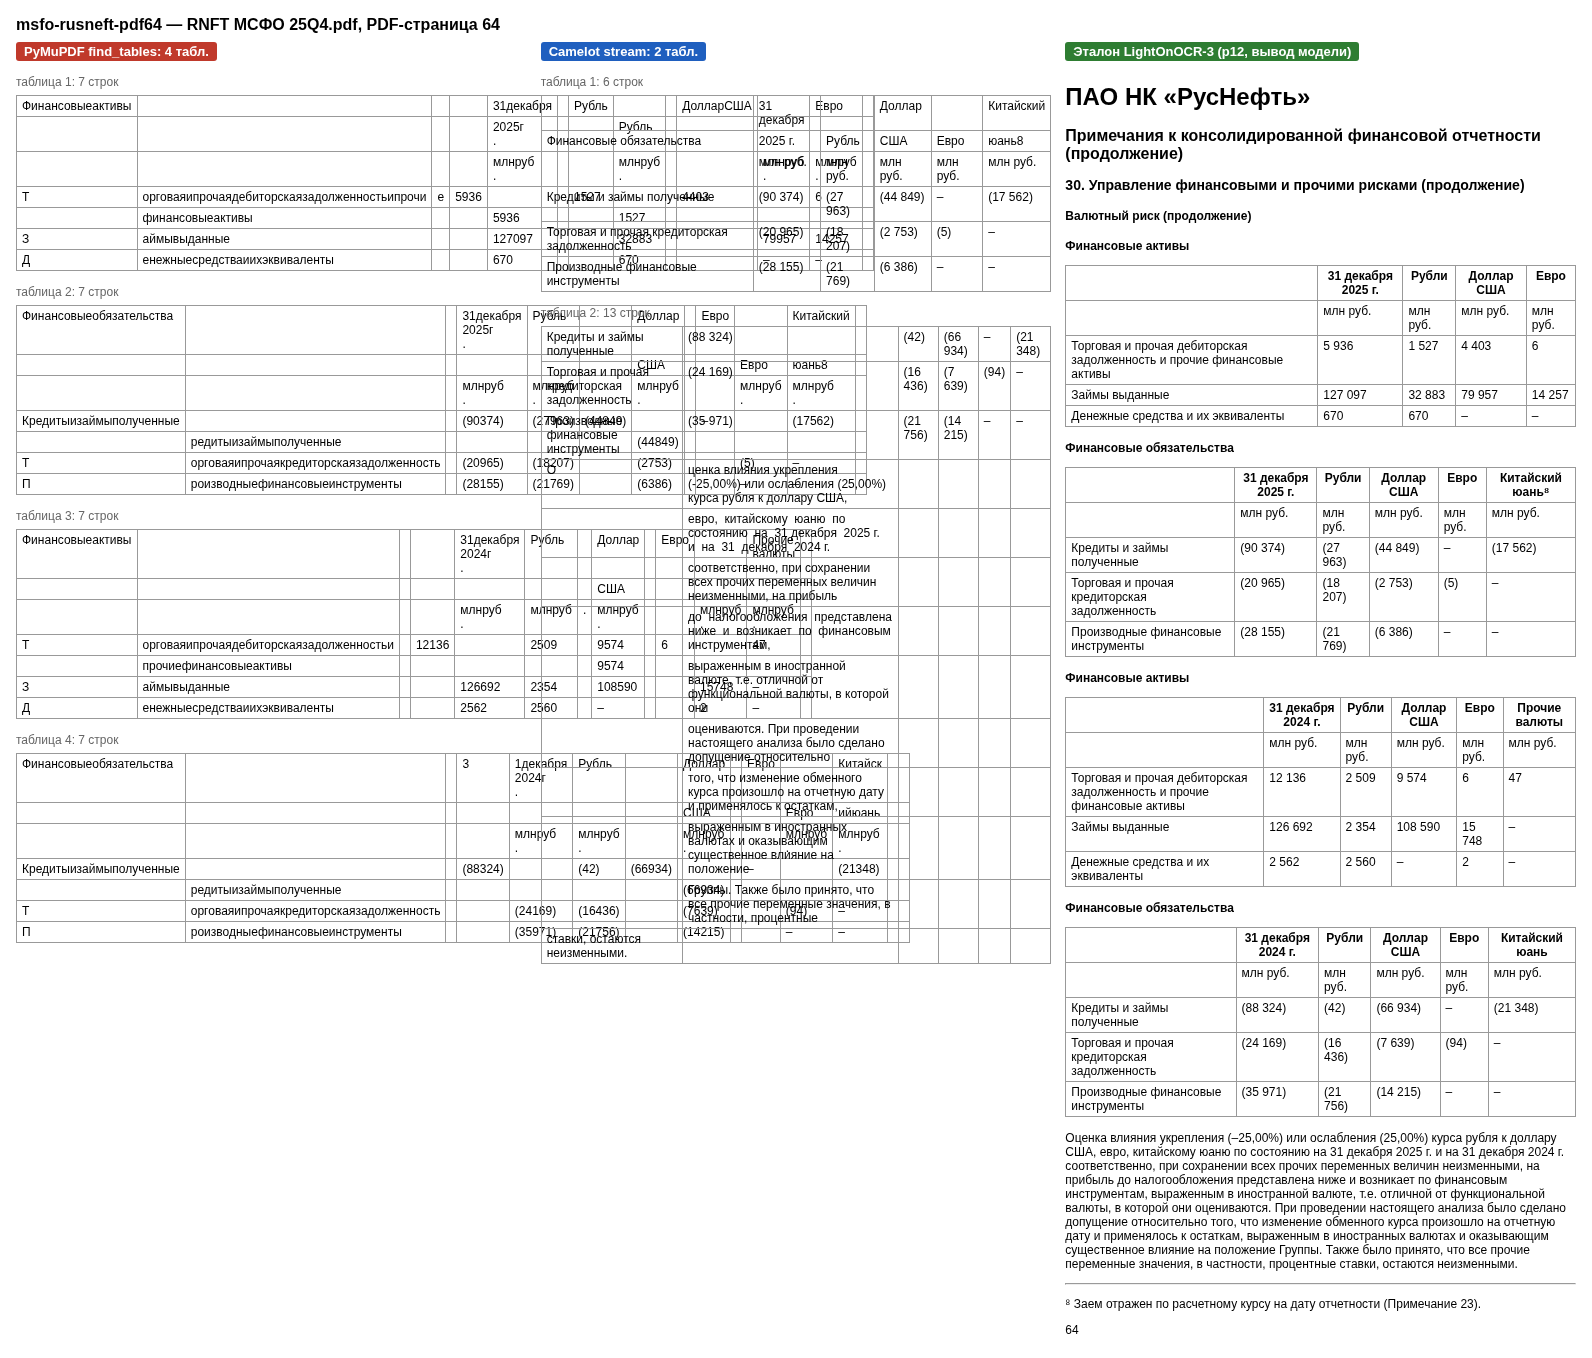
4. Пример, где Camelot лучше. На странице 78 отчёта Россети (справедливая стоимость финансовых инструментов) Camelot дал F1 0.79 против 0.43 у find_tables. find_tables там склеивает слова в ячейках, Camelot сохраняет пробелы и числа с разрядами.
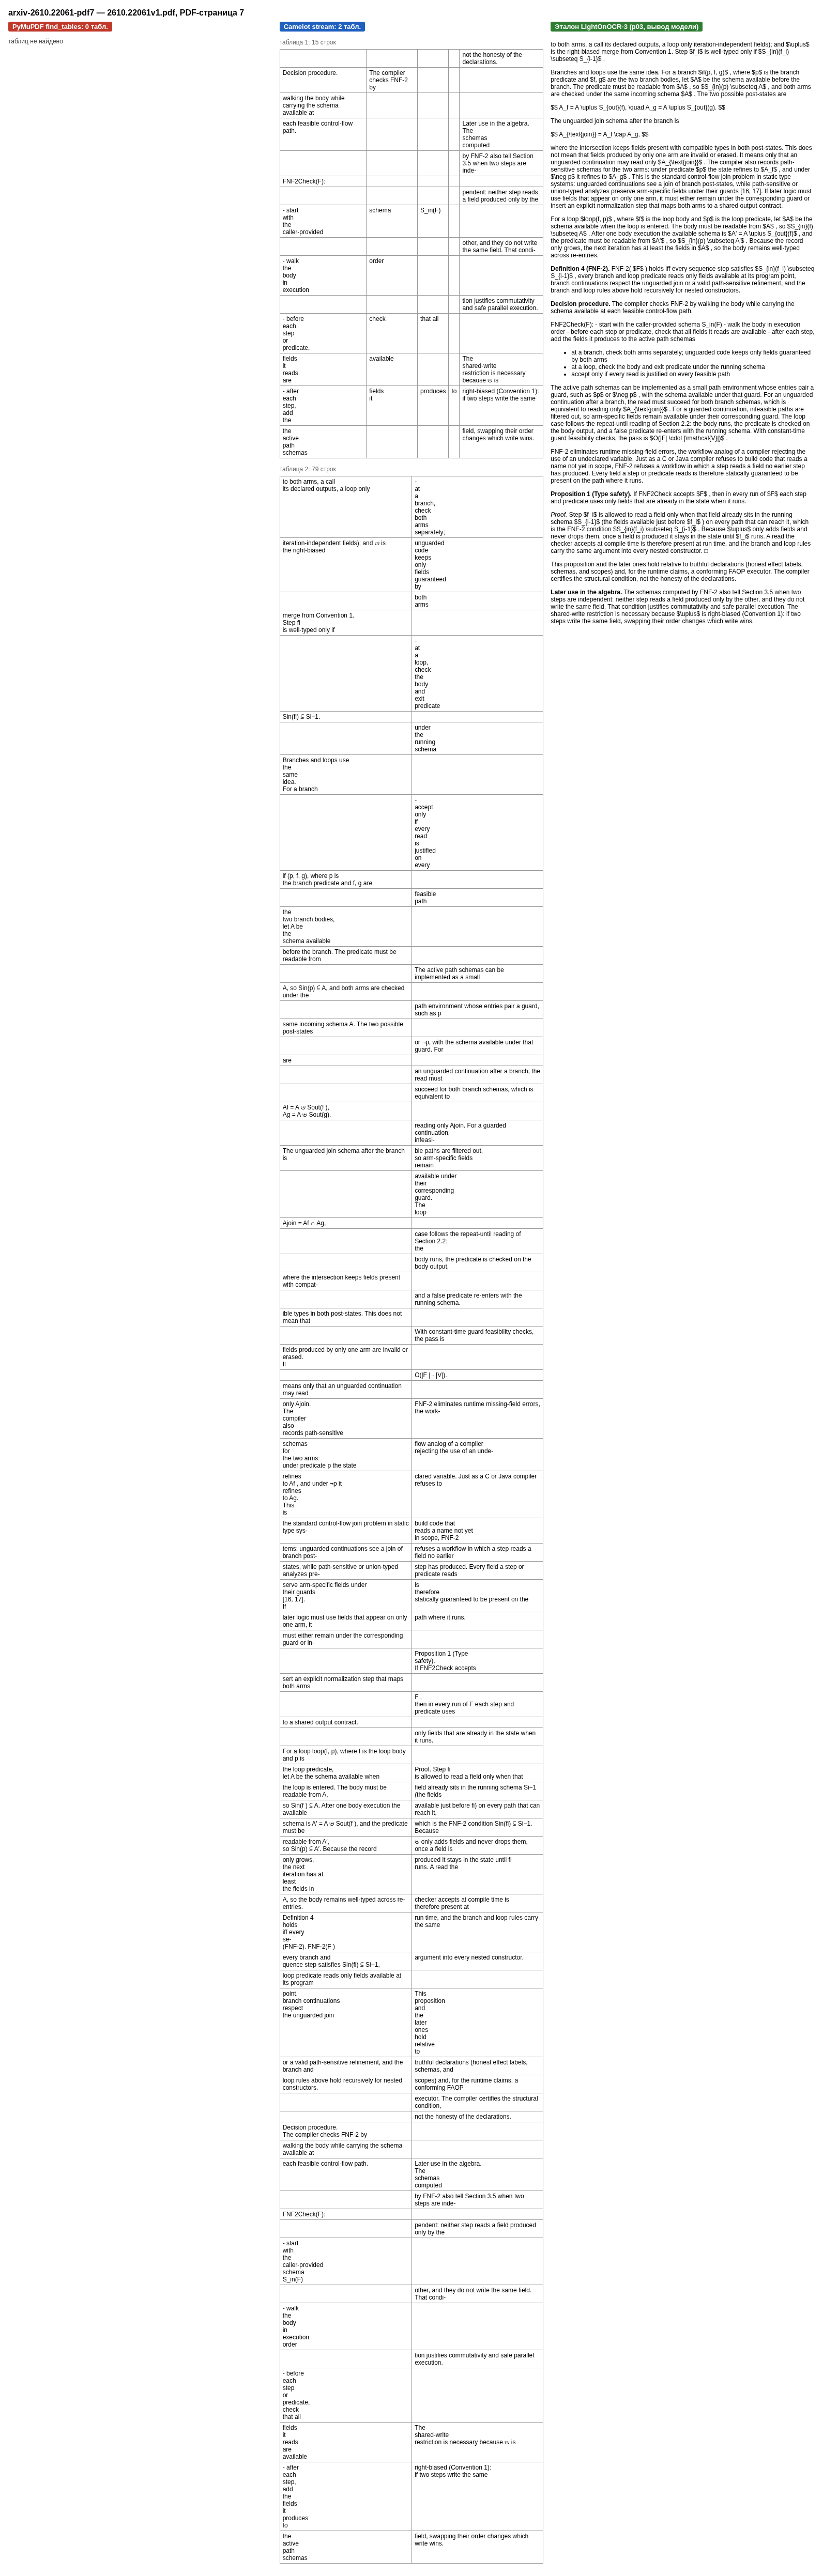
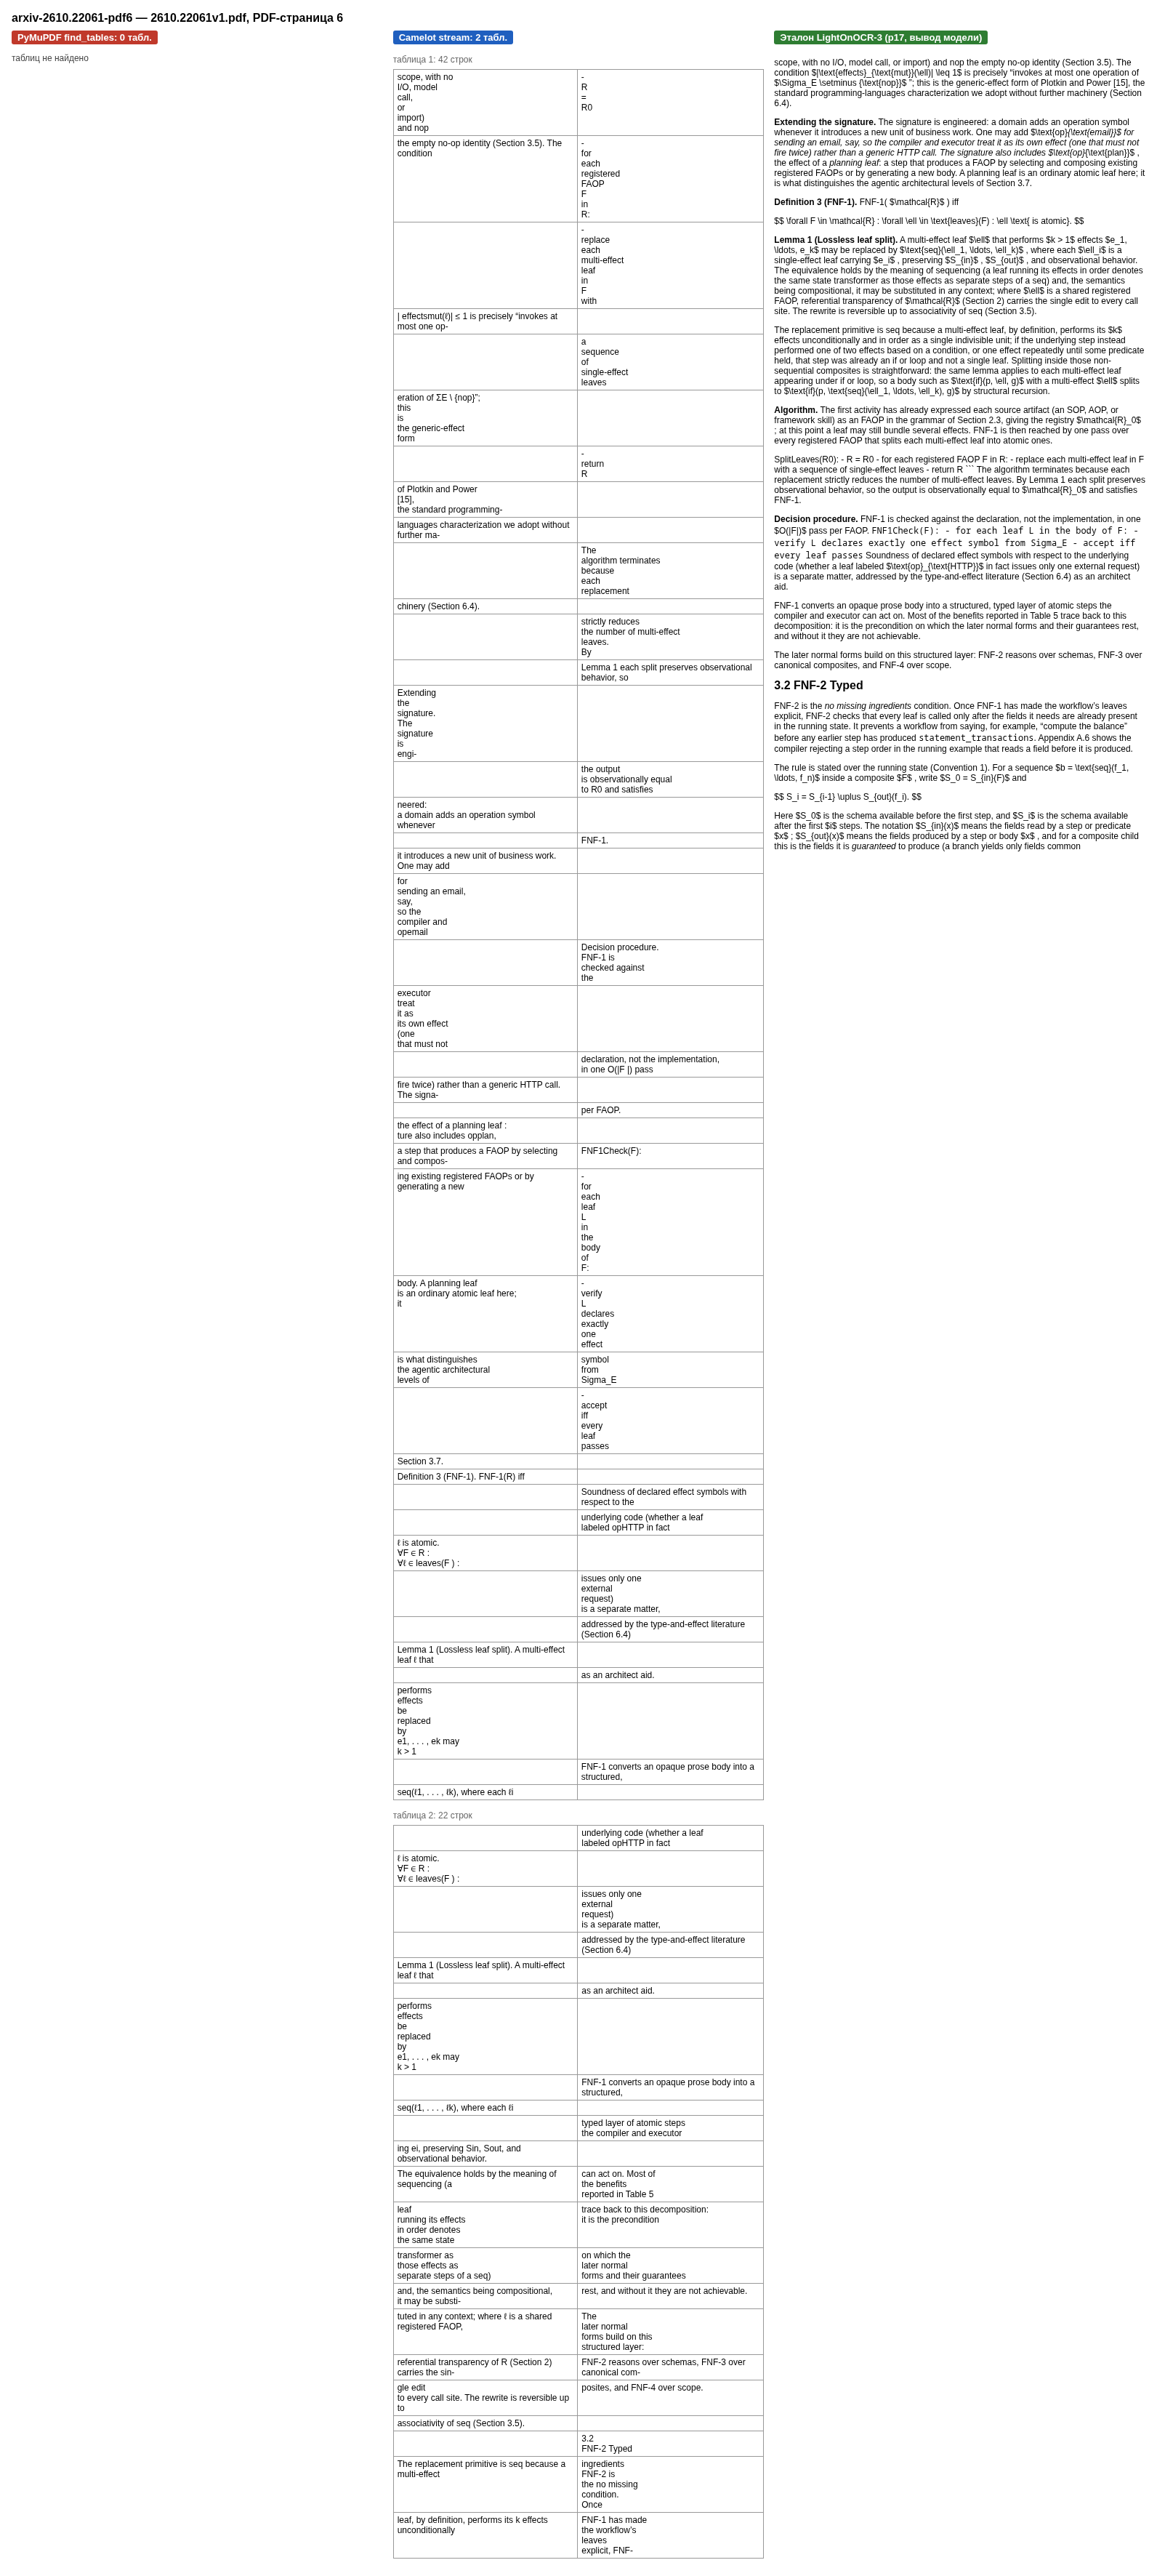
5. Ложные таблицы на препринте. На двух страницах одного препринта arXiv (2610.22061) таблиц нет: текст в две колонки и блоки кода. find_tables не нашёл ни одной. Camelot разбил текст по ячейкам: на седьмой странице «таблица 1» — 18 строк, «таблица 2» — 79 строк, и в них обрывки предложений.
6. Эталон на странице 5 отчёта GCHE. LightOn принял текстовый блок в две колонки за таблицу. Camelot там ничего не вернул из-за отказа на защищённом PDF, так что здесь спорный эталон, а не ошибка метода.
Вывод
- Не брать Camelot как детектор таблиц: stream даёт ложные срабатывания на текстовых страницах, lattice пропускает безлинейные таблицы, оба падают на защищённых PDF.
- Lattice годится только для таблиц с линиями, и то при условии, что кто-то заранее отличит такую страницу. Этот отбор не замерен.
- Выигрыш по скорости (в 7 раз) и по ячейкам на числовых таблицах МСФО у stream реальный, но его нельзя получить, не отсекая ложные таблицы.
- Непроверенная возможность: принимать таблицу Camelot только там, где find_tables тоже нашёл таблицу. Это должно убрать ложные срабатывания на текстовых страницах, но не замерено.
Ограничения
- 36 страниц — малая выборка. Эталон — OCR, поэтому часть страниц сравнивается по картинкам, а не по цифрам.
- Метрика по словам занижает оба метода; решения принимались по содержимому ячеек и по глазам.
- Lattice измерен через бэкенд pdfium (
pypdfium2), без ghostscript. Три ложные таблицы lattice на страницах без таблиц (препринты) глазами не проверялись. - Одна машина, один прогон времени на страницу.
Related
- [[table-structure]] — восстановление сетки ячеек по изображению (TableFormer, SLANet, TATR)
- [[pdf-native-or-ocr]] — выбор между текстовым слоем и OCR для страницы
- [[pdf-parsers]] — сравнение парсеров PDF по тексту и порядку чтения